 纯度AI
api.lmuai.ai 中转站评测
结论:api.lmuai.ai 的综合可信度为 A。67 份检测报告的中位分是 92.5 分,91% 的报告通过,Claude 真伪验证通过率 95.1%,没有报告出现严重问题。
- A综合可信度
- 92.5中位分
- 67检测次数
- 第 54 名排行榜名次
api.lmuai.ai 评测结论
- 检测报告
- 67 份2026-08-19 至 2026-10-12
- 报告通过比例
- 91%严重问题 0 份
- 得分范围
- 49.6–99.3标准差 11.6
- 近期趋势
- 稳定后期比前期 -0.6 分
- Claude 真伪验证
- 95.1%思维签名检测 41 次
- 协议合规
- A+
- 长上下文
- 500k最高已验证的 token 数
总体建议日常开发生产环境(谨慎)
- Claude 思维签名未通过:41 次检测里有 2 次
适合的使用场景
- Claude Code / Cursor 编程thinking 签名 95% + 结构化输出 90%
- ChatGPT 套壳 / 聊天应用基础请求 100% + 流式一致性 95%
- Function Calling / Agent 应用function_calling 86% + structured_output 100%
- Gemini 套壳 / 长文本应用基础请求 100% + 模型信息 100%
- Gemini Function Callingfunction_calling 100%
评测说明
这份评测基于 Veridrop 对 api.lmuai.ai 的 67 份独立检测报告,时间跨度 2026-08-19 至 2026-10-12,覆盖 Claude、Gemini、OpenAI 协议。综合可信度评级为 A(A+ 最高,F 最低),协议合规评级 A+。
得分方面,中位分 92.5 分,最低 49.6 分,最高 99.3 分,标准差 11.6。近期趋势稳定(后期比前期低 0.6 分)。
91% 的报告结论为“通过”;67 份报告里没有一份出现严重问题。
真伪验证方面,Claude 的思维签名检测做了 41 次,通过率 95.1%。思维签名由 Anthropic 的服务端加密生成,中转站无法伪造,是 Veridrop 判断背后是不是真 Claude 模型的最主要依据。
长上下文:最高已验证 500k(按 token 计)。
关键检测项的通过率
Claude 协议
| 检测项 | 检测次数 | 通过 | 未通过 | 通过率 |
|---|---|---|---|---|
| token 用量 | 40 | 21 | 19 | 52.5% |
| 模型身份 | 41 | 29 | 12 | 70.7% |
| 行为特征 | 40 | 35 | 5 | 87.5% |
| 多次请求一致性 | 41 | 36 | 5 | 87.8% |
| 响应完整性 | 40 | 38 | 2 | 95% |
| 思维签名(加密级真伪验证) | 41 | 39 | 2 | 95.1% |
| 协议合规 | 41 | 41 | 0 | 100% |
| 消息编号格式 | 41 | 41 | 0 | 100% |
Gemini 协议
| 检测项 | 检测次数 | 通过 | 未通过 | 通过率 |
|---|---|---|---|---|
| 结构化输出 | 5 | 0 | 5 | 0% |
| 模型信息 | 5 | 5 | 0 | 100% |
| 协议合规 | 5 | 5 | 0 | 100% |
| token 用量 | 5 | 5 | 0 | 100% |
| 函数调用 | 5 | 5 | 0 | 100% |
| 基础请求 | 5 | 5 | 0 | 100% |
| 响应完整性 | 5 | 5 | 0 | 100% |
OpenAI 协议
| 检测项 | 检测次数 | 通过 | 未通过 | 通过率 |
|---|---|---|---|---|
| token 计费 | 21 | 15 | 6 | 71.4% |
| 函数调用 | 21 | 18 | 3 | 85.7% |
| 响应完整性 | 21 | 20 | 1 | 95.2% |
| 结构化输出 | 21 | 21 | 0 | 100% |
| 协议合规 | 21 | 21 | 0 | 100% |
| 基础请求 | 21 | 21 | 0 | 100% |
| 模型一致性 | 21 | 21 | 0 | 100% |
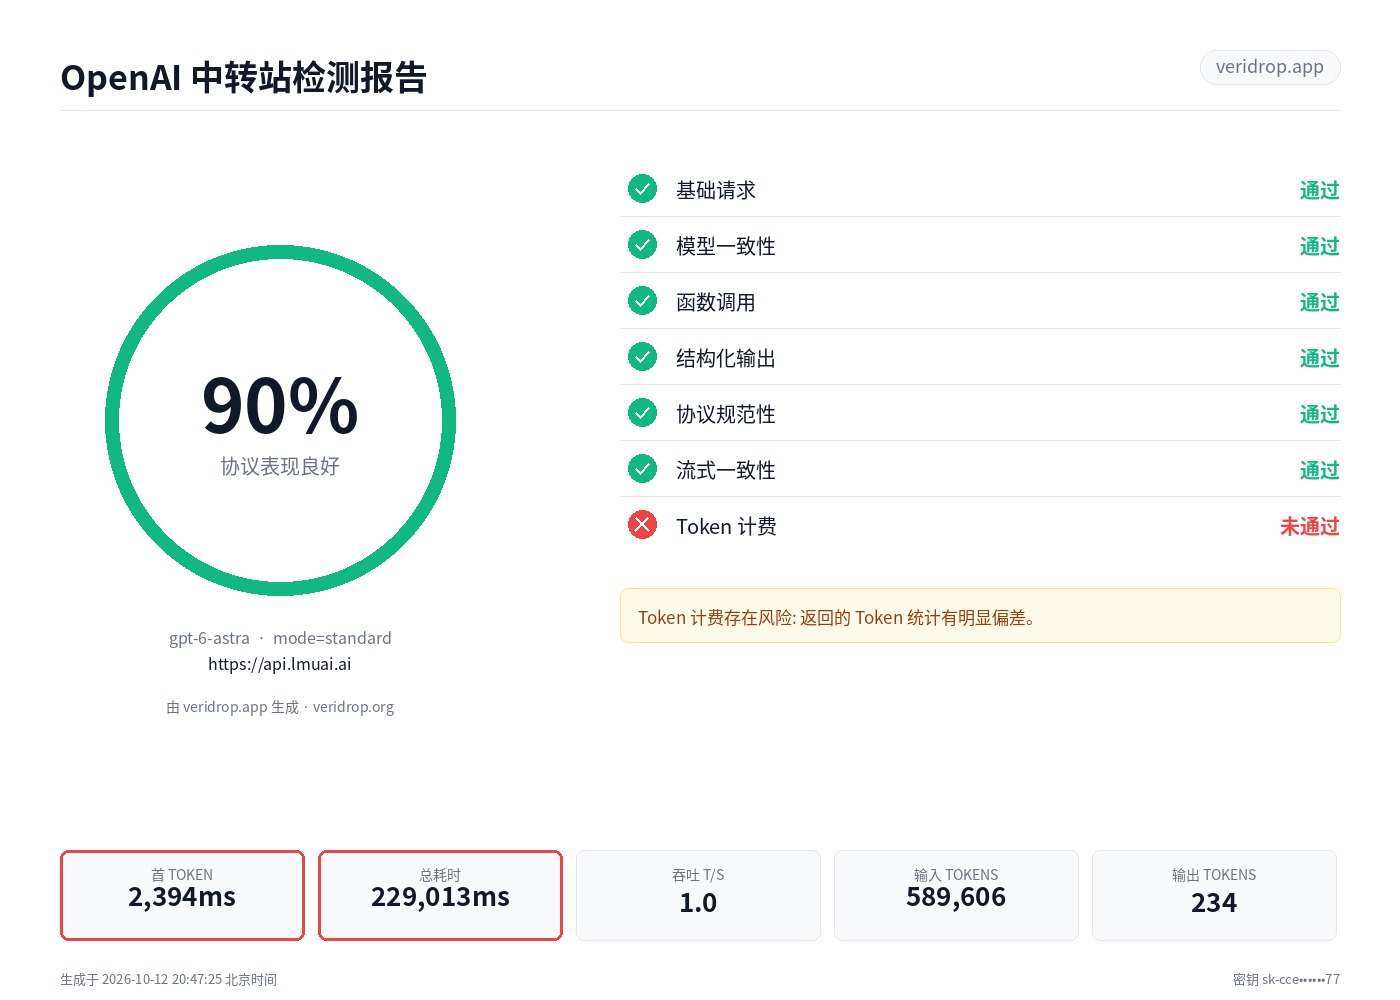
api.lmuai.ai 各模型的检测情况
| 模型 | 协议 | 检测次数 | 中位分 | 最近检测 |
|---|---|---|---|---|
| gpt-5-6 | OpenAI | 9 | 99.2 | 2026-09-18 |
| claude-opus-5 | Claude | 7 | 85 | 2026-10-11 |
| claude-sonnet-5 | Claude | 3 | 66.8 | 2026-09-29 |
| claude-opus-4-8 | Claude | 2 | 91.8 | 2026-09-18 |
| gpt-5-5 | OpenAI | 2 | 90.2 | 2026-09-18 |
| claude-fable-5 | Claude | 1 | 91.8 | 2026-08-28 |
| claude-opus-4-7 | Claude | 1 | 96.4 | 2026-09-18 |
| claude-sonnet-4-6 | Claude | 1 | 98.6 | 2026-09-18 |
最近的检测记录
| 日期 | 协议 | 模型 | 得分 | 结论 | 报告 |
|---|---|---|---|---|---|
| 2026-10-12 | OpenAI | gpt-6-astra | 90.3 | 通过 | 查看 |
| 2026-10-12 | Claude | claude-opus-5-5 | 90.8 | 通过 | 查看 |
| 2026-10-12 | OpenAI | gpt-6-astra | 92.5 | 通过 | 查看 |
| 2026-10-12 | Claude | claude-opus-5-5 | 98.8 | 通过 | 查看 |
| 2026-10-12 | Claude | claude-fable-5-1 | 95.9 | 通过 | 查看 |
| 2026-10-12 | Claude | claude-opus-5-5 | 90.8 | 通过 | 查看 |
| 2026-10-11 | Claude | claude-opus-5-5 | 86.8 | 通过 | 查看 |
| 2026-10-11 | Claude | claude-opus-5 | 90 | 通过 | 查看 |
| 2026-10-11 | Claude | claude-opus-5 | 85 | 通过 | 查看 |
| 2026-10-10 | OpenAI | gpt-6-astra | 94.6 | 通过 | 查看 |
| 2026-10-09 | OpenAI | gpt-6-astra | 93.8 | 通过 | 查看 |
| 2026-10-08 | Claude | claude-fable-5-1 | 95.9 | 通过 | 查看 |
| 2026-10-08 | Claude | claude-opus-5-5 | 89.5 | 通过 | 查看 |
| 2026-10-07 | Claude | claude-opus-5-5 | 89.5 | 通过 | 查看 |
| 2026-10-06 | Claude | claude-opus-5-5 | 85 | 通过 | 查看 |
| 2026-10-04 | OpenAI | gpt-6.1-sol | 96.8 | 通过 | 查看 |
| 2026-10-04 | Claude | claude-opus-5-5 | 85 | 通过 | 查看 |
| 2026-09-30 | Claude | claude-opus-5-5 | 98.6 | 通过 | 查看 |
| 2026-09-30 | Claude | claude-opus-5-5 | 92.7 | 通过 | 查看 |
| 2026-09-30 | Claude | claude-opus-5-5 | 86.8 | 通过 | 查看 |
- 最近检测
- ,结论“通过”
- 测评生成
- ,由 Veridrop 按公开规则从检测报告自动汇总
- 数据来源
- Veridrop 上 api.lmuai.ai 的检测页
关于 api.lmuai.ai 的常见问题
api.lmuai.ai 靠谱吗?
按 Veridrop 的自动测评,api.lmuai.ai 的综合可信度是 A(A+ 最高,F 最低),依据是 67 份检测报告:中位分 92.5 分,91% 的报告结论为“通过”,没有报告出现严重问题,在 Veridrop 榜单上排第 54 名。测评给出的总体建议是:日常开发、生产环境(谨慎)。测评只看接口返回的内容,不涉及价格、稳定性和售后。
api.lmuai.ai 给的是真的 Claude 模型吗?
Veridrop 对 api.lmuai.ai 做过 41 次 Claude 思维签名检测,通过率 95.1%。思维签名由 Anthropic 的服务端加密生成,中转站无法伪造;通过率越接近 100%,说明请求越稳定地到达了真实的 Claude 模型。这是历史检测的统计,不保证你下一次请求的结果。
api.lmuai.ai 适合用来做什么?
测评认为适合的场景:Claude Code / Cursor 编程(thinking 签名 95% + 结构化输出 90%);ChatGPT 套壳 / 聊天应用(基础请求 100% + 流式一致性 95%);Function Calling / Agent 应用(function_calling 86% + structured_output 100%);Gemini 套壳 / 长文本应用(基础请求 100% + 模型信息 100%);Gemini Function Calling(function_calling 100%)。这些结论由各检测项的通过率按固定规则得出。
这份评测是怎么做出来的?
Veridrop 向中转站发送一组探针请求,检查返回的是不是它声称的模型、功能是否完整、协议是否合规、token 计费是否准确,每次检测生成一份报告。自动测评把同一个站点的全部报告按公开的规则汇总成等级和通过率,不由人工打分,也不使用大模型撰写。本站只展示结果。
怎么自己验证 api.lmuai.ai?
到 Veridrop 的检测页填入 api.lmuai.ai 的接口地址和你自己的 key,几分钟后得到一份报告。key 只用于这一次检测。
在用别的中转站?到 Veridrop 免费检测,或者回到中转站排行榜看前 100 名。