 纯度AI
用 Grok Bot 做视频:让 AI 写代码渲染成片的八步流程
根据 @leo_xiaolei 的长文整理:用 Grok Bot 的云电脑让 AI 写前端代码、逐帧截图、合成视频,不靠文生视频模型。讲清原理、要装的三个 Skill、从选题到成片的八个步骤,以及审片和声音上最容易踩的坑。
本文根据公开分享整理,本站尚未实测。操作前请对照文末的原始来源。
本页目录(15 节)
这篇教程解决一个问题:不用剪辑软件,也不靠文生视频模型“抽卡”,让 Grok Bot 写代码把一条带配音、字幕和配乐的竖屏短片做出来。
方法来自 X 用户 @leo_xiaolei 的一篇长文,他说自己用这套流程做了六条片子。本文把其中的原理和步骤整理出来,并对照 Grok Bot 的官方文档核对了能核对的部分。文中的示意图和代码来自原文和作者的 Gist。
先说清楚它适合做什么:
| 适合 | 不适合 |
|---|---|
| 数据图表、知识科普、产品演示、文字动效、要精确卡点的讲解片 | 写实的光影、人脸、自然景观 |
后一类仍然要用文生视频模型。这套流程的好处是画面完全可控:改一处,重新渲染一遍,其他画面不会变。
原理:视频是“算”出来的
整条流水线是这样的:
文字需求 → 模型写出网页动画代码(HTML / Canvas)
→ 无头浏览器按时间点逐帧截图(每秒 30 到 60 张)
→ ffmpeg 把图片序列和配音合成 MP4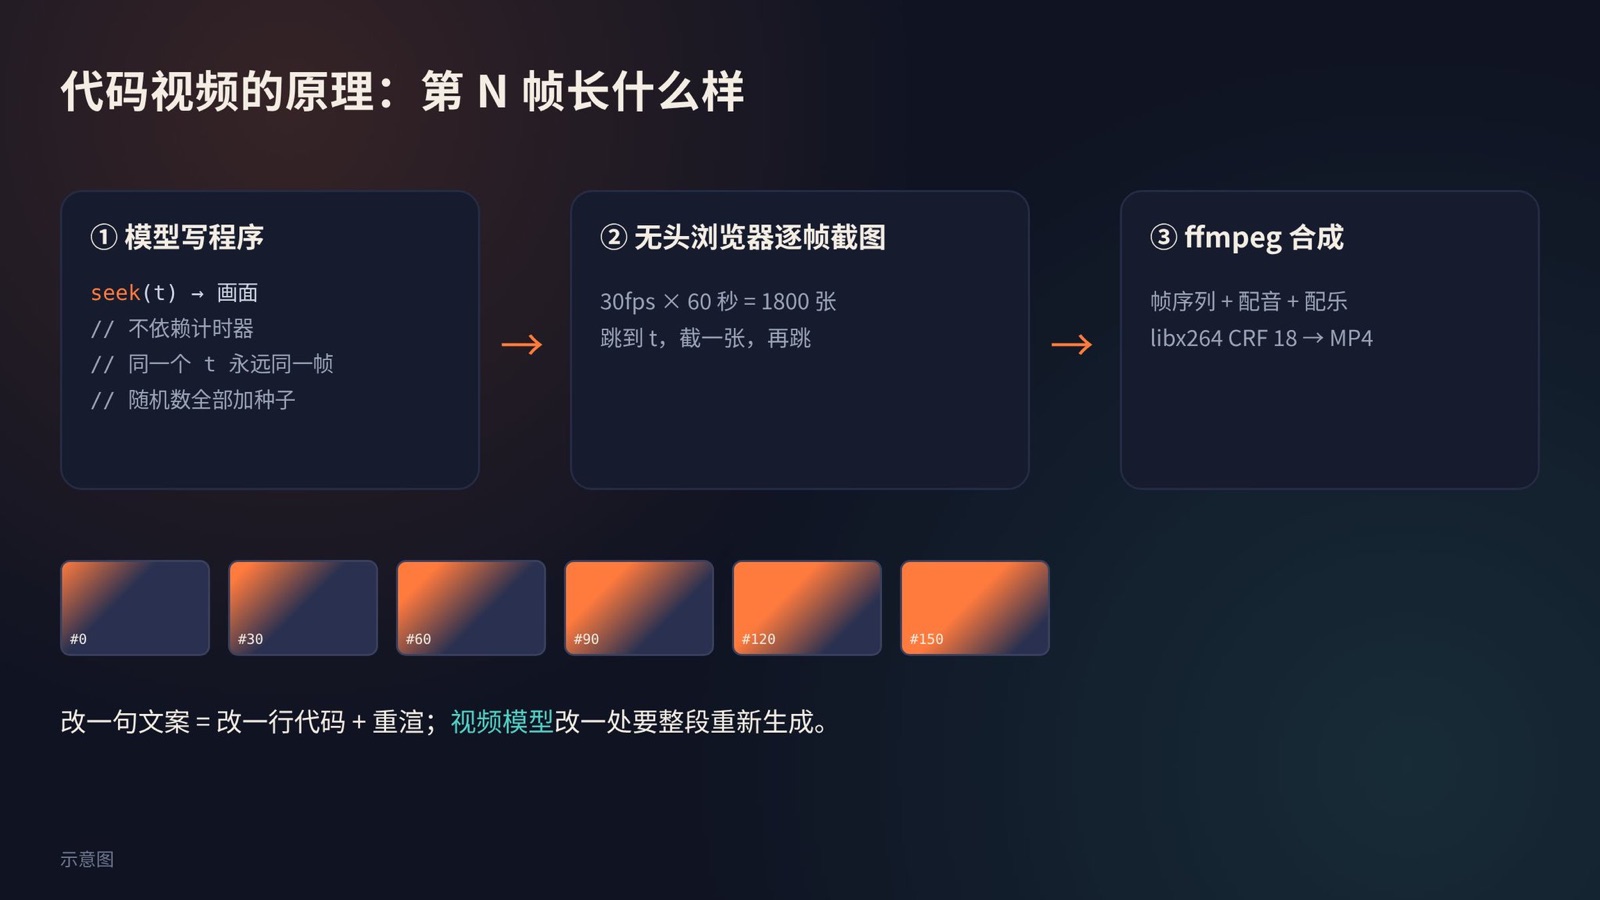
有两个机制决定了成片的质量。
用 seek(t),不用系统时钟。 普通网页动画跟着系统时钟走,而无头浏览器截一张图要几十到上百毫秒,截图跟不上动画,一丢帧音画就错位。所以页面要暴露一个函数 window.seek(t):给它一个时间 t,它只根据这个数算出所有元素的位置并画出这一帧。同一个 t 永远得到同一张图。
配音是时钟。 先用 edge-tts 生成配音,同时拿到每个词开口的时间点,存成一份时间戳文件。画面里每个元素的出现、变色都挂在某个词的时间上,口播念到哪个词,画面就在那一刻动。作者提醒:edge-tts 默认只返回整句的边界,要词级时间戳得显式传 boundary='WordBoundary'。
这也意味着所有随机效果(粒子、噪点)都要用固定的随机种子,在页面加载时生成一次,seek(t) 里只读不生成,否则同一帧渲染两次会不一样。作者用的是一个带种子的随机数函数:
function mulberry32(a) {               // 32 位种子随机数,同一个种子永远得到同一串数
  return function () {
    a |= 0; a = a + 0x6D2B79F5 | 0;
    let t = Math.imul(a ^ a >>> 15, 1 | a);
    t = t + Math.imul(t ^ t >>> 7, 61 | t) ^ t;
    return ((t ^ t >>> 14) >>> 0) / 4294967296;
  };
}
const rnd = mulberry32(42);
const stars = Array.from({ length: 80 }, () => ({ x: rnd() * 1080, y: rnd() * 1920 }));
一个能直接跑的最小例子
下面三段代码来自作者的 Gist,合起来就是这条管线的最小版本:画一条复利曲线,口播念到哪个词,那个词就出现在屏幕上。
页面(保存为 index.html):只根据 t 画出一帧,不读系统时钟。
<!doctype html>
<html><head><meta charset="utf-8">
<style>html,body{margin:0;background:#0f1322}canvas{display:block}</style></head>
<body><canvas id="c" width="1080" height="1920"></canvas>
<script>
const c = document.getElementById('c').getContext('2d');
const W = 1080, H = 1920;
const TIMING = window.TIMING || [];               // render.py 注入 timing.json
// cue('贫穷') 返回这个词开始说出的秒数;edge-tts 的分词不一定和你想的一样,所以用包含匹配
const cue = w => (TIMING.find(x => x.word.includes(w)) || { start: 0 }).start;
const ease = x => 1 - Math.pow(1 - x, 3);
const k = (t, t0, d) => ease(Math.max(0, Math.min(1, (t - t0) / d)));

window.seek = function (t) {                      // 只读 t,不读系统时钟
  c.fillStyle = '#0f1322'; c.fillRect(0, 0, W, H);
  // 一条从左下往右上长的线:长度跟着口播走
  const grow = k(t, cue('复利'), 1.2);
  c.strokeStyle = '#4fd1c5'; c.lineWidth = 14; c.lineCap = 'round';
  c.beginPath(); c.moveTo(140, 1200);
  for (let i = 0; i <= 60 * grow; i++) {
    const x = i / 60; c.lineTo(140 + x * 800, 1200 - (Math.exp(3 * x) - 1) / (Math.exp(3) - 1) * 800);
  }
  c.stroke();
  // 念到哪个词,哪个词砸进来
  c.textAlign = 'center'; c.font = 'bold 150px "Noto Sans CJK SC", sans-serif';
  const now = TIMING.filter(x => x.start <= t).pop();   // 同一时刻只画一个词
  if (now) {
    const w = now, a = k(t, w.start, 0.12), out = k(t, w.end + 0.15, 0.2);
    c.globalAlpha = a * (1 - out);
    c.fillStyle = '#ff7a3d';
    c.save(); c.translate(W / 2, 330); c.scale(1.3 - 0.3 * a, 1.3 - 0.3 * a);
    c.fillText(w.word, 0, 0); c.restore();
  }
  c.globalAlpha = 1;
};
</script></body></html>配音和词级时间戳(保存为 tts_words.py):
# 用法:uv run --with edge-tts python tts_words.py "要念的句子" voice.mp3 timing.json
import asyncio, json, sys
import edge_tts

text, mp3, js = sys.argv[1], sys.argv[2], sys.argv[3]

async def main():
    tts = edge_tts.Communicate(text, 'zh-CN-YunxiNeural', rate='+15%',
                               boundary='WordBoundary')   # 默认是整句,改成按词
    words = []
    with open(mp3, 'wb') as f:
        async for chunk in tts.stream():
            if chunk['type'] == 'audio':
                f.write(chunk['data'])
            elif chunk['type'] == 'WordBoundary':
                # offset 和 duration 的单位是 100 纳秒
                words.append({'word': chunk['text'],
                              'start': round(chunk['offset'] / 1e7, 3),
                              'end': round((chunk['offset'] + chunk['duration']) / 1e7, 3)})
    json.dump(words, open(js, 'w'), ensure_ascii=False, indent=1)
    print(len(words), 'words', words[:4])

asyncio.run(main())
运行它:
uv run --with edge-tts python tts_words.py "懒惰会复利成贫穷,拖延会复利成错失机会。" voice.mp3 timing.json得到的时间戳文件是这样的。注意 edge-tts 把“懒惰会”切成了一个词,所以页面里找词用的是“包含”匹配:
[{"word": "懒惰会", "start": 0.093, "end": 0.583},
 {"word": "复利", "start": 0.593, "end": 0.8},
 {"word": "成", "start": 0.8, "end": 0.941},
{"word": "贫穷", "start": 0.952, "end": 1.463}]渲染脚本(保存为 render.py):用 Playwright 打开页面,每隔 1/30 秒调用一次 seek 并截图,最后交给 ffmpeg。
# 用法:uv run --with playwright python render.py
# 首次运行前装浏览器:uv run --with playwright playwright install chromium
import json, pathlib, subprocess
from playwright.sync_api import sync_playwright

FPS = 30
timing = json.load(open('timing.json'))
dur = timing[-1]['end'] + 0.8                       # 最后一个词说完再停 0.8 秒
out = pathlib.Path('frames'); out.mkdir(exist_ok=True)
with sync_playwright() as p:
    b = p.chromium.launch()
    pg = b.new_page(viewport={'width': 1080, 'height': 1920})
    pg.add_init_script(f'window.TIMING = {json.dumps(timing, ensure_ascii=False)};')
    pg.goto(pathlib.Path('index.html').resolve().as_uri())
    n = round(dur * FPS)
    for i in range(n):
        pg.evaluate(f'window.seek({i / FPS})')      # 第 i 帧 = 第 i/FPS 秒
        pg.screenshot(path=str(out / f'{i:05d}.png'))
    b.close()
subprocess.run(['ffmpeg', '-y', '-v', 'error', '-framerate', str(FPS), '-i', 'frames/%05d.png',
                '-c:v', 'libx264', '-crf', '18', '-pix_fmt', 'yuv420p', 'silent.mp4'], check=True)
print(f'{n} frames, {dur:.2f}s -> silent.mp4')
作者说,在 Grok Bot 的云电脑上这个脚本 10 秒左右渲完 120 帧(4 秒视频),同一帧渲两遍得到的图片完全一样。
开工前:认识 Grok Bot 的云电脑
按官方文档,Grok Bot 的 Bot 工作在一台持久化的云端电脑上,带浏览器、命令行和文件系统,你合上笔记本它也会继续。有三点和做视频直接相关:
- 你账户里的所有 Bot 共用这一台电脑。 文件、浏览器登录状态、命令行凭据都是共享的,一个 Bot 装好的东西另一个 Bot 能用。
- 项目文件放在
/workspace。 官方说明:电脑更新会保留文件和登录信息,但会移除你手动安装的应用和软件包。 - 屏幕分辨率是 1920×1200。 2026 年 10 月 7 日的更新从 1280×800 提上来的。
针对第二点,作者的做法是把 Playwright、Chromium、ffmpeg 和中文字体(思源黑体或 Noto Sans CJK)的安装命令写成一个 init_env.sh 放在工程根目录,哪次命令报错了,先让 Bot 跑一遍这个脚本。
关于模型:你选不了。 官方帮助中心写明,Grok Bot 没有模型选择器,每个任务由系统选用它认为最合适的模型,你也看不到用的是哪一个。同一页还说明,任务被交给 Opus 5.5 并不会让每个 token 的消耗变多。
要装的三个 Skill
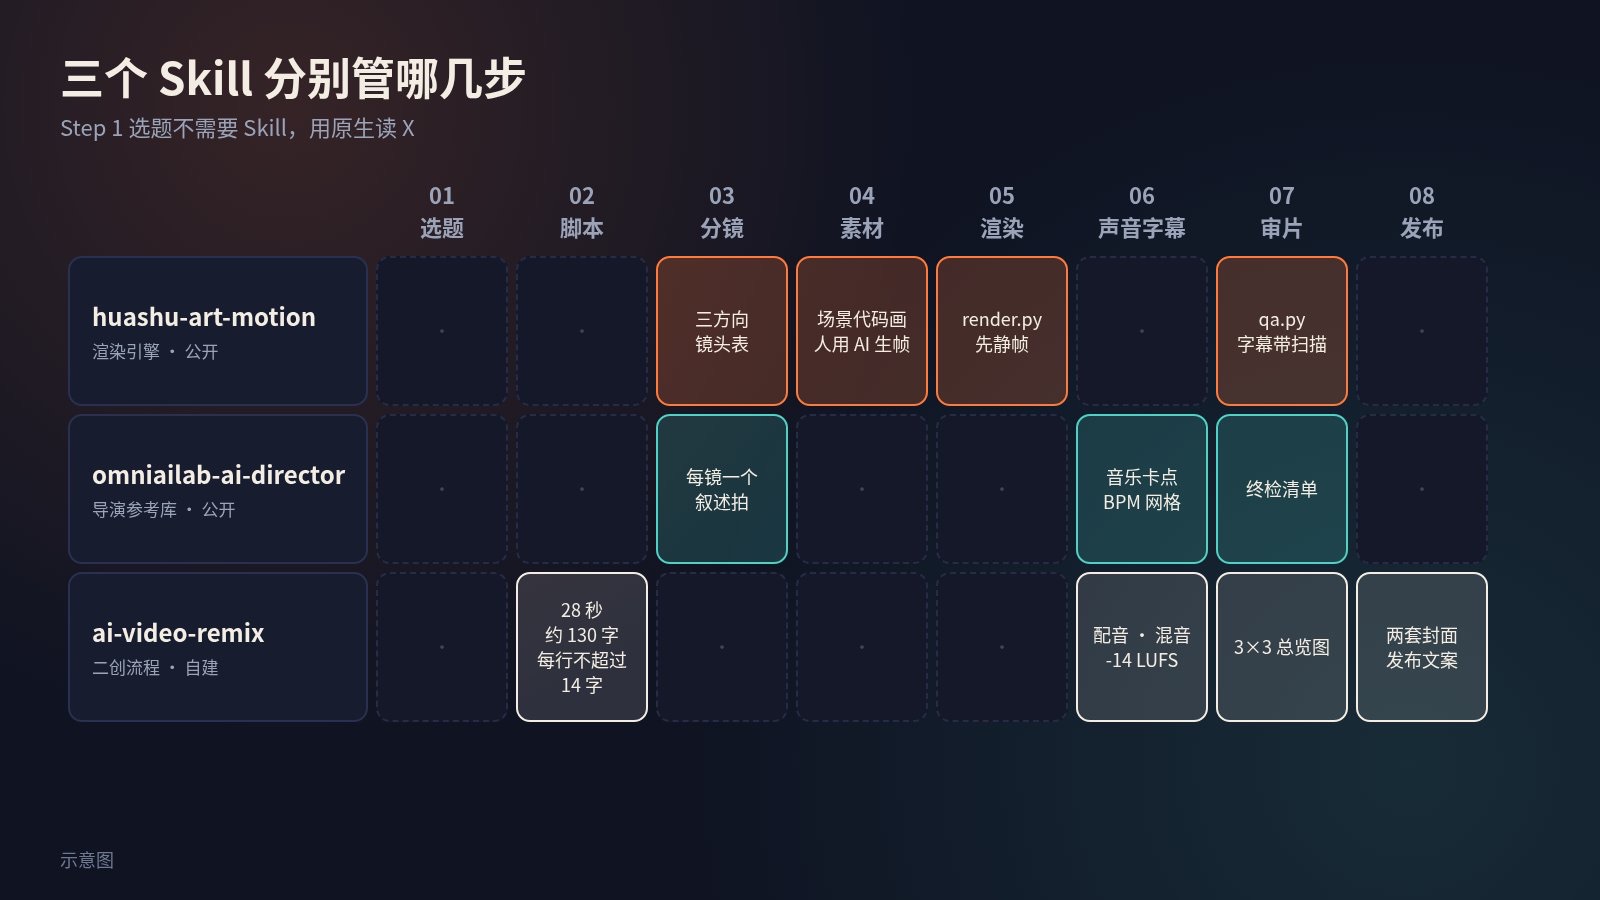
Skill 是一份可复用的做事说明,存好以后你名下的每个 Bot 都能调用。作者的流水线靠三个 Skill:
| Skill | 管什么 | 来源 |
|---|---|---|
| huashu-art-motion | “画”和“渲”:内置 35 种艺术风格和 9 种讲解动画语法,带 Canvas 加 Playwright 的渲染引擎和验收脚本 | 花叔开源,MIT 许可 |
| omniailab-ai-director | “判断”:镜头该讲什么、用哪种镜头、按什么清单验收。含 157 张动效镜头卡 | OmniAiLab 开源,MIT 许可 |
| ai-video-remix | 二次创作:写解说、配音、混音、烧字幕、出封面 | 作者的 Bot 自己存下来的,没有公开仓库 |
怎么装
公开仓库的装法:把 GitHub 链接发给 Bot,说一句“安装这个 skill”。huashu-art-motion 的 README 另外给了命令行装法:
npx skills add alchaincyf/huashu-art-motion它依赖 uv、ffmpeg 和 Playwright 的 Chromium,第一次运行前要装浏览器:
uv run --with playwright playwright install chromium另外两种情况:
- 自己的 Skill:先完整做完一条片子,再对 Bot 说“把我们这次做片的流程存成一个技能,叫某某”。官方文档推荐的也是这个顺序:先做一次,做稳了存成技能,最后才做成定时任务。
- 调用:官方文档说在输入框里输入
/可以引用技能;私有技能没出现的话,到“设置 > 插件 > 你的”里给当前 Bot 启用。
装 omniailab-ai-director 时作者交代 Bot 的几条规矩,值得照做:
- 只当参考资料用,不登录、不付费、不下载它的客户端。
- 不使用其中
references/MUSIC-SCENE SKILL.md这份文件。作者的理由是里面有规避平台版权检查的做法。 - 它的 README 写附带 154 份音效,作者的 Bot 实际只找到 11 个 mp3,其中 6 个查不到出处。商用前要自己核对授权。
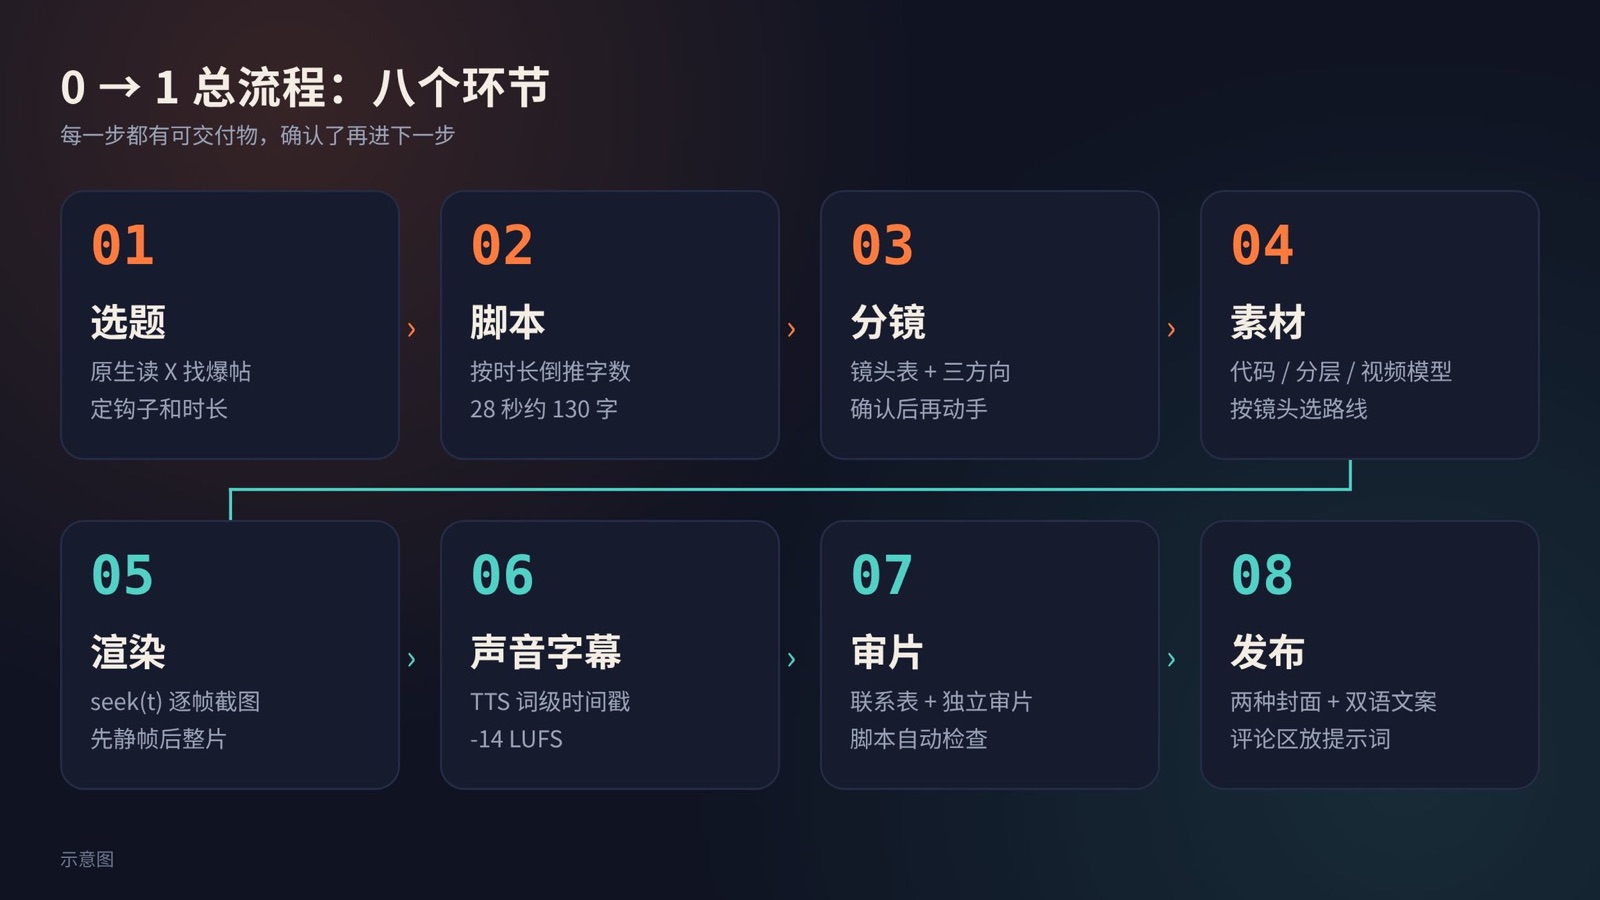
八个步骤总览
1用 X 上的真实讨论定选题
Grok Bot 可以直接搜索和阅读 X。让 Bot 做三件事:
- 找出目标领域近三天收藏最多的十条视频推文;
- 拆解它们的前三秒:用了什么画面,前两句话抛出了什么冲突;
- 找出评论区里点赞最多、被问得最多的三个争议点。
脚本直接回应这三个争议点。作者给的额度数字是每分钟 30 次、每天 1000 次读取;本站没有在官方文档里核对到这个数字,以你账户里显示的为准。
2先定时长,再倒推字数
- 竖屏 28 秒的解说,口播文案控制在 130 字上下。
- 每行字幕不超过 14 个汉字;讲解类动画更短,每块不超过 10 个字。
- 配音语速上浮 5% 到 15%。
- 把配音导出的词级时间戳文件当作整个工程的时间基准,转场、动效、高亮都挂在它上面。
做二次创作时,第一句必须是钩子:两秒内说完,要有观点,不能只描述画面。
3分镜表,开头先写“事实边界”
让 Bot 在写代码之前先交一份分镜表:每段的起止时间(精确到 0.1 秒)、口播台词、画面主体、辅助文字和动效。
最重要的是分镜表开头的事实边界。给开源项目做宣传片时,仓库里往往没有成品截图,模型会自作主张编出一堆不存在的界面。所以要它先写明:
- 哪些展示是项目真实具备的;
- 哪些前后对比是为了视觉效果生成的示意画面;
- 所有不是真实界面的画面,角落都标上“示意画面”。
同时让它针对同一个核心镜头给出 A、B、C 三种不同画风的静态预览图,你选定一种再往下做。作者用的指令是这样的:
用 huashu-art-motion 和 omniailab-ai-director 这两个技能,把下面这段口播做成竖屏讲解动画。
先出镜头表,每个镜头写清叙事任务;再把关键帧做成 A/B/C 三个方向给我挑,我选定之前不渲整片。
口播:<原文>4按镜头的性质选素材路线
没有一种方案能搞定所有镜头,按性质分四条路线:
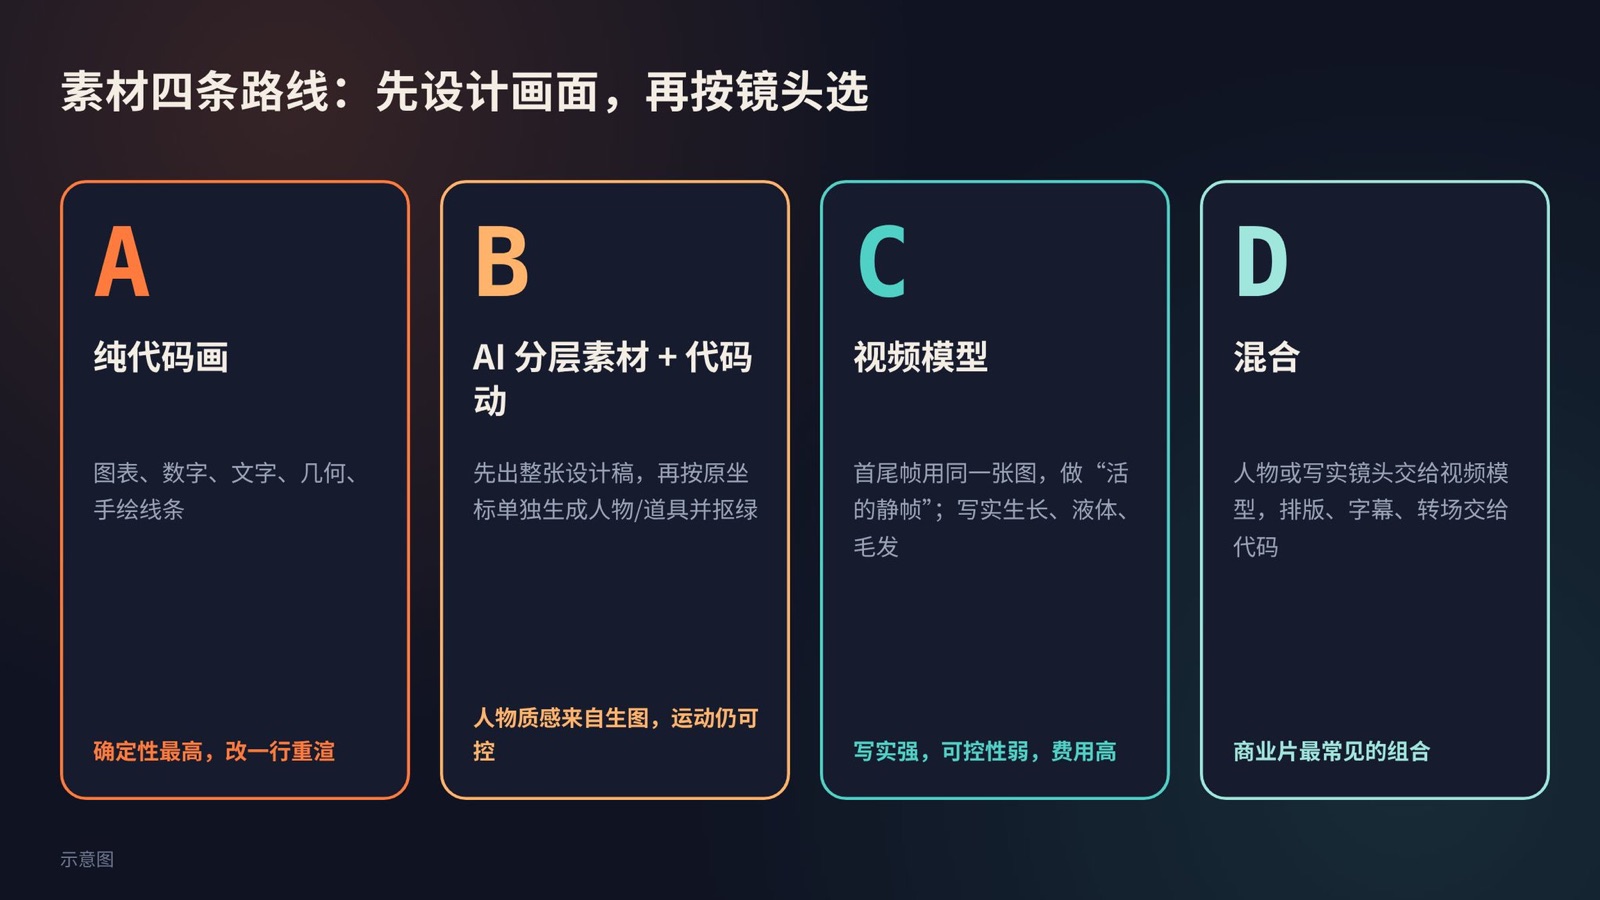
| 镜头 | 路线 |
|---|---|
| 几何图形、图表、排版、终端界面 | 纯代码绘制(Canvas 或 SVG),不依赖素材 |
| 具体的物体、有质感的插画 | AI 生成一张纯白底的图,代码负责让它动 |
| 液体、生长这类复杂的形变 | 用视频生成工具做几秒的片段,当作局部素材 |
| 手机或电脑屏幕上的操作 | AI 生成一张空白发光的倾斜屏幕,脚本把真实录屏做透视变换贴进去 |
生图时的几条规矩:
- 图里不要字。 图像模型写出来的字几乎都是错的,文字统一由代码叠加。
- 做前后对比时,先生成“之后”,再拿它当参考生成“之前”,构图和人物才对得上。
- 配色写到具体部位,比如“橘猫:头和背是橘色,下巴和肚子是白色”,否则每张图都不一样。
5静帧确认之前,不渲整片
一分钟、每秒 30 帧的视频要截 1800 张图,作者说他的一条宣传片单次渲染就要二十多分钟。所以提示词里要写死:静帧没有经你确认之前,不许启动整片渲染。
装了 huashu-art-motion 之后,Bot 会用它的引擎先出静帧、再渲整片、最后跑验收脚本。作者给出的命令顺序是这样的,其中 $E 是引擎所在的目录:
# 1. 第一次用先装浏览器
uv run --with playwright playwright install chromium
# 2. 只渲某个镜头的关键静帧(0、0.3、0.6 是镜头内的进度)
uv run --with playwright python $E/render.py --solo <镜头id> --stills 0,0.3,0.6 --out 渲染/<镜头id>
# 3. 静帧通过肉眼审查后,渲整片并合入音频
uv run --with playwright python $E/render.py --out 成片.mp4 --audio 配乐.wav
# 4. 运行质检脚本和字幕带扫描
uv run scripts/qa.py --project <工程>
uv run --with numpy python scripts/subzone_gate.py 成片.mp4
不装 Skill 也可以:前面那个 index.html 加 render.py 就是这条管线的最小版本。
6声音和字幕
业余和专业的差别,往往不在画质,而在这里。
字幕字号有单位陷阱。 用 ASS 格式烧录字幕时,字号和网页里的像素不是一回事。作者以思源黑体为例:字的实际大小等于 Fontsize 除以 1.448,想要 96 像素的字要填 139。换了字体,先烧一帧量一下。
竖屏的安全区(1080×1920,作者几个项目里摸索出来的版面):
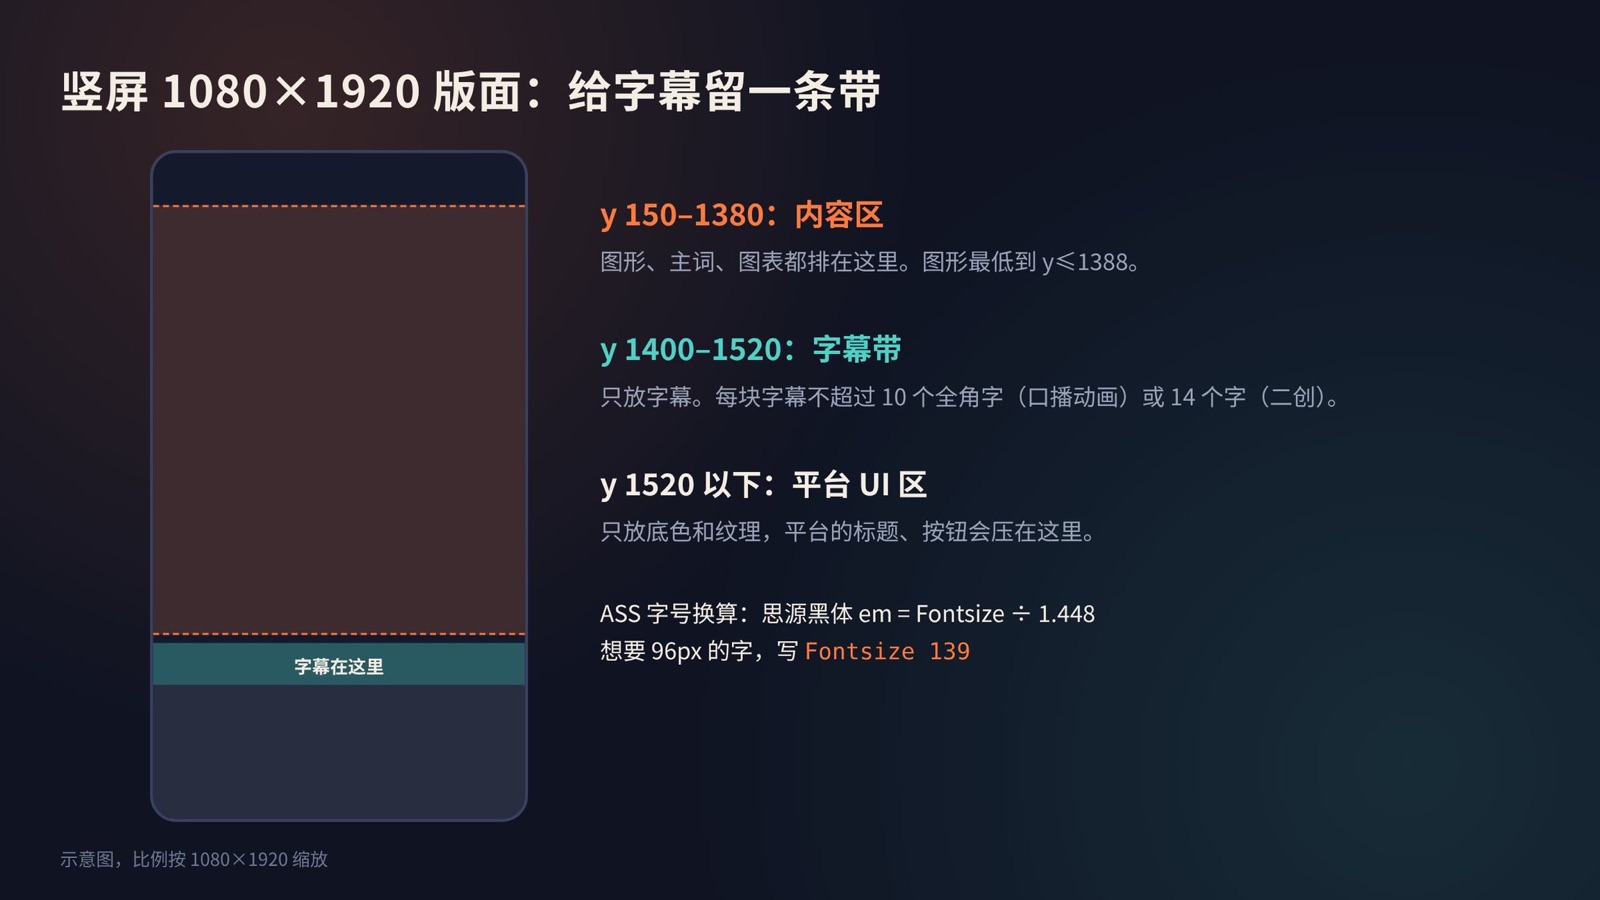
| 位置 | 用途 |
|---|---|
| y 1388 以上 | 图表、人物、道具都不能低于这条线 |
| y 1400 到 1520 | 只放字幕 |
| y 1520 以下 | 只放底色。平台的昵称、文案和按钮会压在这里 |
各家平台的界面高度不完全一样,宁可多留一点。
混音的指标
- 成片整体响度 -14 LUFS,真峰值不超过 -1.5 dBTP。
- 人声 -16 LUFS。
- 有人说话时背景音乐自动压低,停顿时再抬起来(侧链闪避)。
这些用 ffmpeg 一个脚本就能做。作者的 mix.sh:口播当侧链把音乐压下去,再用两遍 loudnorm 把成片调到 -14 LUFS。
#!/usr/bin/env bash
# 用法:bash mix.sh voice.mp3 music.wav 片长秒数
# 口播当侧链,把音乐压下去;再两遍 loudnorm 把母带调到 -14 LUFS、真峰值 -1.5 dBTP
set -euo pipefail
V=$1; M=$2; D=$3
ffmpeg -y -v error -i "$V" -i "$M" -filter_complex \
"[0:a]aresample=48000,aformat=channel_layouts=stereo,apad=whole_dur=$D,asplit=2[v][sc];\
[1:a]volume=-12dB[m];\
[m][sc]sidechaincompress=threshold=0.015:ratio=20:attack=20:release=300[duck];\
[v][duck]amix=inputs=2:duration=first:normalize=0" premix.wav
# 第一遍:只测量
J=$(ffmpeg -hide_banner -nostats -i premix.wav -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null - 2>&1 | sed -n '/^{/,/^}/p')
g(){ echo "$J" | python3 -c "import json,sys;print(json.load(sys.stdin)['$1'])"; }
# 第二遍:带着测量值做线性归一
ffmpeg -y -v error -i premix.wav -af "loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=$(g input_i):measured_TP=$(g input_tp):measured_LRA=$(g input_lra):measured_thresh=$(g input_thresh):offset=$(g target_offset):linear=true,aresample=48000" master.wav
# 验收:看 Integrated loudness 和 True peak
ffmpeg -hide_banner -nostats -i master.wav -af ebur128=peak=true -f null - 2>&1 | sed -n '/Summary/,$p' | grep -E ' I:|Peak:'
作者在 4 秒的示例上量过:说话时的音乐比停顿时低约 11 dB,成片落在 -14.5 LUFS、真峰值 -1.5。想压得更狠,就把 threshold 调低、ratio 调高。
7审片,模型“看不了视频”怎么办
这是最容易翻车的一步。模型能看图,但不能直接看视频回放。你问它成片怎么样,它只能凭几张截图回答。作者的办法是把视频转成它能看的东西:
成片 → 每 0.5 秒抽一帧 → 拼成一张带时间码的大图(联系表)
→ 开一个新会话 → 给它联系表、响度报告和原始分镜表
→ 让它逐格找问题:遮挡、错别字、穿模、跳帧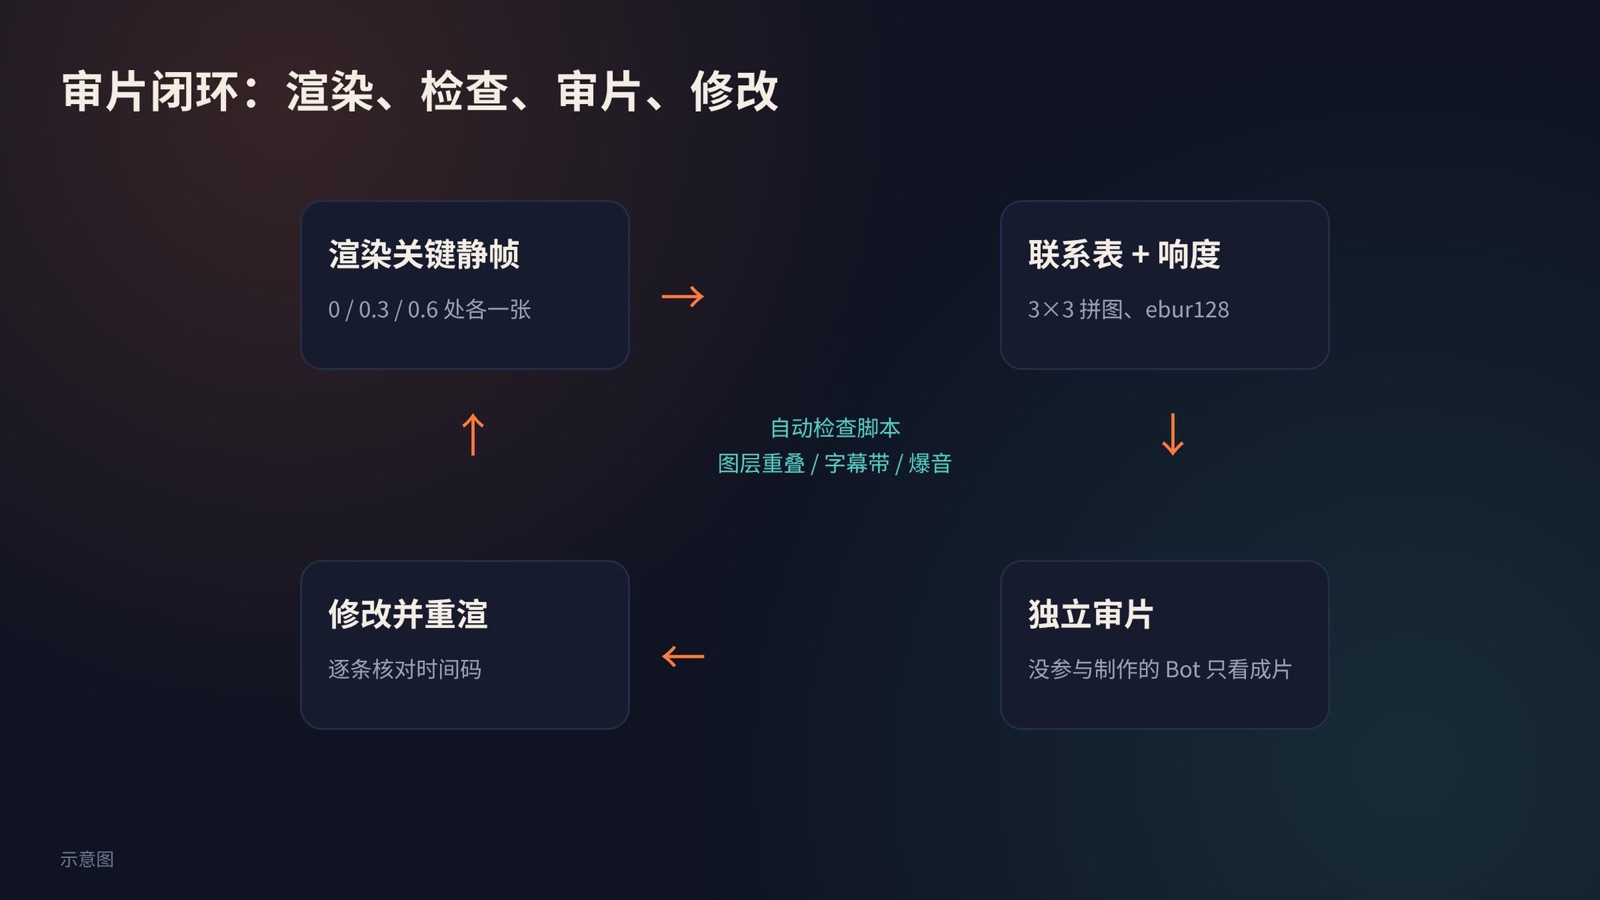
三个要点:
- 联系表用一条 ffmpeg 命令就能生成(见下)。60 秒的片子是 120 格,可以分成几张。
- 不要让写代码的那个会话审自己的片。 新开一个 Bot 会话,不给它看任何制作过程,只给联系表、响度报告和分镜表,让它专门挑毛病。审片意见也要逐条核对:作者收到的意见里就有一条是误判。
- 声音必须你自己听。 机器能查响度,查不了语气。作者的 Bot 交片时自己都说“配音我这边没法试听”。成片出来后戴上耳机完整听一遍。
生成联系表的命令。字体路径是云电脑上 Noto Sans CJK 的位置,tile 的格数按片长来定:
ffmpeg -y -v error -i final.mp4 -vf "fps=2,scale=216:-1,drawtext=fontfile=/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc:text='%{pts\:hms}':x=6:y=6:fontsize=22:fontcolor=white:box=1:boxcolor=black@0.6,tile=4x2" -frames:v 1 contact.png联系表确实能抓到问题。作者的 4 秒示例里,第一版在 0.5 秒那一格有两个词叠在一起,改成同一时刻只画一个词之后才对:
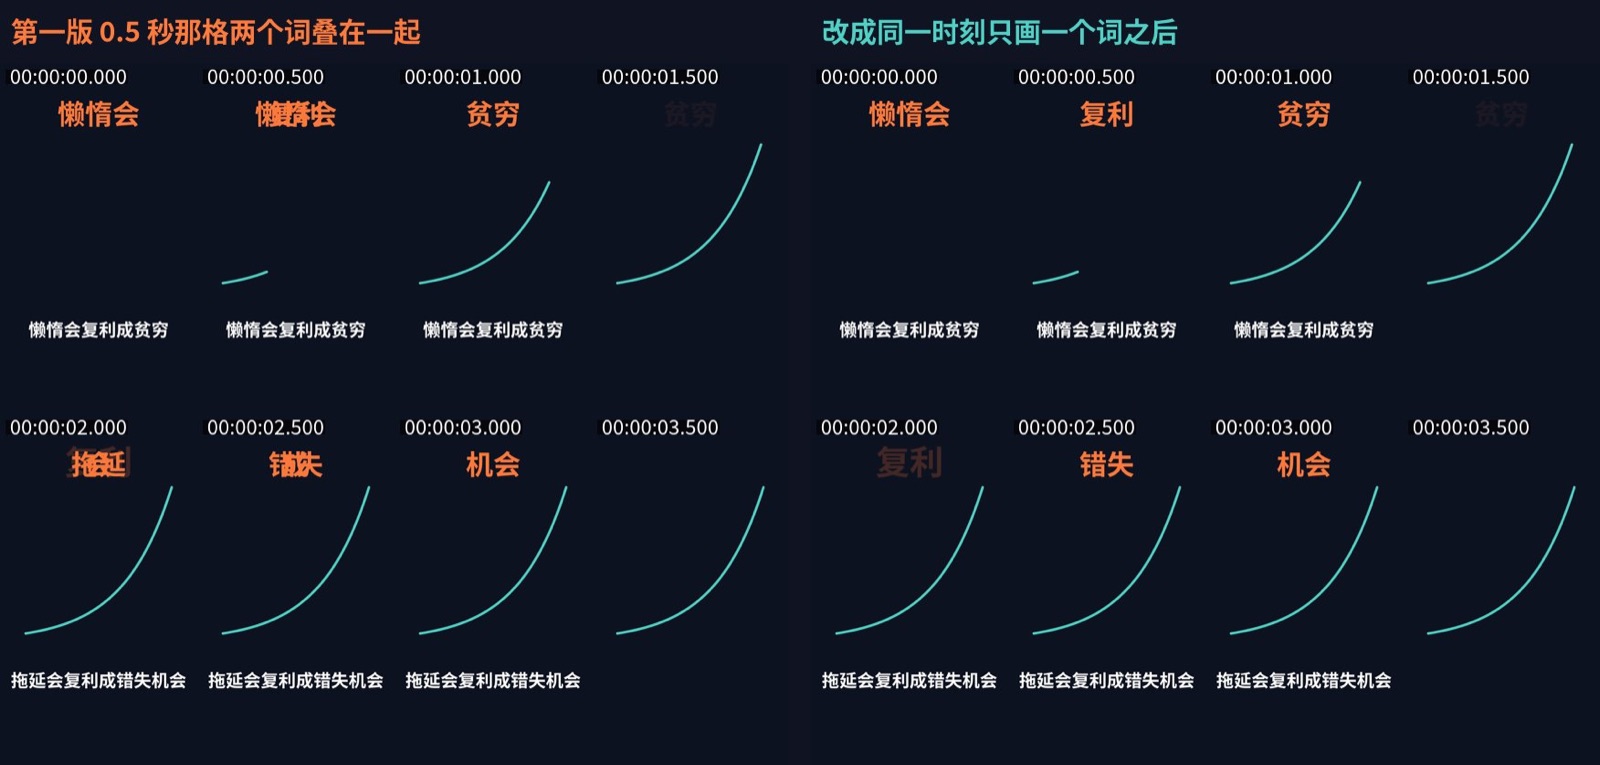
8压制和发布
- 用
libx264,画质参数 CRF 18,并加上-movflags +faststart。最后这个参数把索引信息移到文件开头,网页和手机上可以边下边播。 - 封面出两套:9:16 的给 X、视频号、TikTok,3:4 的给小红书和公众号。
- 主帖放成片和一句钩子,详细的思路、参数和提示词放在第一条评论里。
- 用了 AI 生成的画面就标“AI 生成”。 二次创作别人的素材,不要去水印,加上自己的原创解说,并在简介里写明素材来源。
常见的翻车和解决办法
这张表整理自原文的避坑清单:
| 现象 | 原因 | 解决办法 |
|---|---|---|
| 成片像流水账的幻灯片 | 没给具体的风格参考,模型退回到默认的渐变加大字 | 给一两个具体的风格标杆(比如“Kurzgesagt 扁平信息图风”)或参考视频,并写明“每个镜头画面必须有动态变化” |
| 管道命令把报错吞掉了 | 脚本里用了 python render.py | tail -1,Bash 管道只看最后一个命令的退出码,前面报错也返回 0 |
脚本开头加 set -eo pipefail,任何一步报错立刻停下 |
| 画面前后物品突然变样 | 多个镜头分别调用生图工具独立生成,特征对不上 | 先生成最终的结果图,再以它为参考生成过程图 |
| 想指定 Opus 5.5 却找不到开关 | Grok Bot 没有模型选择器,由系统按任务选 | 把质量要求写进任务说明:先交静帧、附联系表、列出没检查到的地方 |
| 中文全部变成方块 | 云电脑初始化后缺少中文字体 | 安装思源黑体或 Noto Sans CJK,用 fc-list :lang=zh 检查,并写进初始化脚本 |
| 背景音效有轻微的“咔哒”声 | 代码合成的音效起振太硬,没有做淡入 | 加 2 到 12 毫秒的淡入和 8 毫秒的尾部淡出,再加一个限幅器 |
| 画面里出现乱码一样的文字 | 让图像模型画了文字 | 图像模型只负责背景或物体,文字由代码叠加 |
| 审片意见和画面对不上 | 审片给的时间码会偏一两秒,个别意见是误判 | 每条意见都抽出对应的那一帧核对后再改 |
这套流程的局限
作者自己写得很清楚:
- Bot 听不了自己做的配音,也看不全自己的回放。最后一遍得人来看、人来听。
- 模型由系统决定,你指定不了。同样的提示词,不同时候的效果可能不一样。
- 照片级的连续形变(比如植物生长)它画不了,要借视频生成工具。
- 电脑更新后手动装的环境会没,要靠初始化脚本恢复。
从哪里拿代码和提示词
作者把文中用到的全部代码和四个提示词模板放在了一个 Gist 里,共 20 个文件,包括:
| 文件 | 作用 |
|---|---|
index.html、render.py |
最小的渲染管线:一个带 seek(t) 的页面,加逐帧截图的脚本 |
tts_words.py |
用 edge-tts 生成配音和词级时间戳 |
make_ass.py |
把时间戳切成字幕 |
mix.sh |
侧链闪避和响度归一 |
contact-sheet.sh |
生成联系表 |
run_all.sh |
一条命令从配音跑到成片 |
| 四个提示词模板 | 交付说明、独立审片员、每日选题、素材二创 |
把这些文件放进同一个文件夹,装好 uv、ffmpeg 和 Noto Sans CJK 字体,第一次运行前装好 Chromium,然后运行 bash run_all.sh。脚本的内容:
#!/usr/bin/env bash
# 从一句口播到一条带字幕、带配乐的 4 秒竖屏视频。依赖:uv、ffmpeg、Noto Sans CJK 字体
set -euo pipefail
TEXT="懒惰会复利成贫穷,拖延会复利成错失机会。"
uv run --with edge-tts python tts_words.py "$TEXT" voice.mp3 timing.json      # 1 口播 + 词级时间戳
uv run --with playwright python render.py                                       # 2 seek(t) 逐帧截图 → silent.mp4
D=$(python3 -c "import json;print(json.load(open('timing.json'))[-1]['end']+0.8)")
ffmpeg -y -v error -f lavfi -i "aevalsrc='0.2*sin(2*PI*220*t)+0.15*sin(2*PI*277.18*t)+0.15*sin(2*PI*329.63*t)':s=48000:d=$D" -ac 2 music.wav  # 3 占位配乐
bash mix.sh voice.mp3 music.wav "$D"                                            # 4 侧链闪避 + 响度归一 → master.wav
python3 make_ass.py timing.json subs.ass                                        # 5 字幕
ffmpeg -y -v error -i silent.mp4 -i master.wav -vf "ass=subs.ass" \
  -c:v libx264 -crf 18 -pix_fmt yuv420p -c:a aac -b:a 192k -shortest -movflags +faststart final.mp4  # 6 合成
ffmpeg -y -v error -i final.mp4 -vf "fps=2,scale=216:-1,drawtext=fontfile=/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc:text='%{pts\:hms}':x=6:y=6:fontsize=22:fontcolor=white:box=1:boxcolor=black@0.6,tile=4x2" -frames:v 1 contact.png  # 7 联系表
echo done
按作者的说法,他在 Grok Bot 的云电脑上从空目录跑了一遍,14 秒出片:一条 1080×1920、4 秒、带字幕和配乐的 final.mp4,外加一张联系表 contact.png。脚本里的配乐只是三个正弦波叠成的和弦,用来测试音乐的压低效果,正式做片时换成自己的曲子。
Gist 地址:https://gist.github.com/threerocks/5f6f6d5b3801a400bb5343379082580c
原文更长,包含作者做六条片子时的具体经过和四个提示词模板的全文,值得读一遍:https://x.com/leo_xiaolei/status/2108159484401262882