 纯度AI
Harness 工程和 Loop 工程是什么:用 Claude Code 和 Opus 5.5 搭一套规则、检查和循环
根据 @N01ennn 的长文整理并逐条对照它引用的来源:让模型的产出稳定下来,靠的是提示词外面的三样东西,每次都读的规则文件、必须过关的检查、跑到过关为止的循环。以用代码做动画为例,讲清怎么在 Claude Code 里用 CLAUDE.md、skill、/goal 和 /loop 把它们搭起来。
本文根据公开分享整理,本站尚未实测。操作前请对照文末的原始来源。
本页目录(14 节)
这篇教程解决一个问题:同一个模型,怎么让它的产出从“看运气”变成“每次都过得了检查”。 答案不在提示词里,在提示词外面的三样东西:一份它每次都会读的规则文件,几项必须过关的检查,一个跑到过关为止的循环。前两样现在叫 harness 工程,第三样叫 loop 工程。
内容来自 X 用户 @N01ennn 的一篇英文长文。他每周用 Claude Opus 5.5 写代码做动画,拿自己的做法当例子,把 Anthropic 的发布文章、Thoughtworks 的一篇文章、一篇 arXiv 论文、Claude Code 团队的博客和文档、Addy Osmani 和 IBM 的文章串在了一起。本文按“先懂概念、再照着搭”重新整理,并逐条对照了原文列出的 9 个来源。文中的示意图和代码来自原文。
先弄清:原文说得不全或和来源对不上的三处
| 原文的说法 | 来源怎么说 |
|---|---|
/goal 会让 Claude 一直做到条件满足,或者达到轮数上限 |
官方博客也是这样概括的,但 Claude Code 的文档写得更细:/goal 没有内置的轮数上限。它在四种情况下停:评估模型判定条件已满足、判定不可能满足、遇到必须你来处理的错误、你运行 /goal clear。想限制轮数,要把“最多几轮”写进条件里 |
| 恢复会话会带回还在七天有效期内的循环任务 | 只对了一半。固定间隔的任务会恢复;没写间隔、由 Claude 自己定节奏的 /loop 不会恢复,要重新运行 |
Addy Osmani 每天跑五到十个代理、他的 /goal 写法、他差点发出去的一次错误改动 |
原文列出的那篇 Osmani 的文章里没有这些内容。本文只用了那篇文章里核对得到的部分 |
Opus 5.5 的价格、规格和发布文章里的数字,本文和 Anthropic 的原文逐项对过,是一致的。
一张图看懂三层
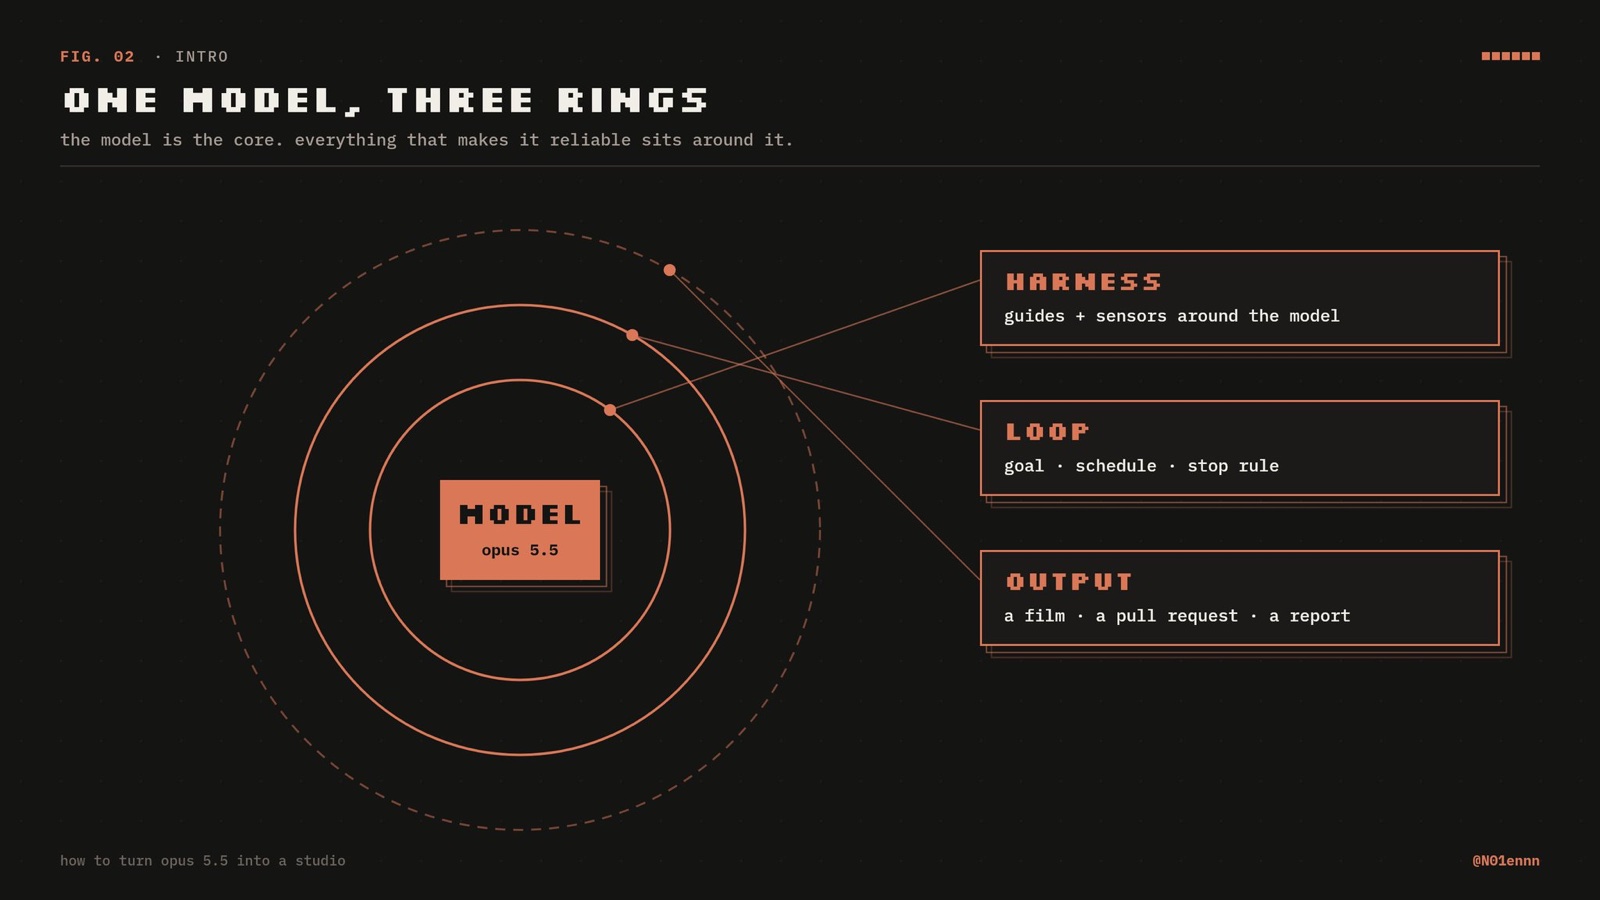
| 名字 | 是什么 | 在 Claude Code 里对应什么 |
|---|---|---|
| 模型 | 中间那个被套住的东西 | Claude Opus 5.5 等 |
| Harness | 模型之外、让一次运行更可靠的一切:事前的规则,事后的检查 | CLAUDE.md、skill、hooks、测试和 lint、负责审查的子代理 |
| Loop | 从外面把“做、查、再做”连起来,不用人每一轮都写提示词 | /goal、/loop、/schedule(云端 routine) |
三个定义各有出处:
- Harness:Thoughtworks 的 Birgitta Böckeler 把它当作“智能体里除了模型以外的一切”的简称,写成 Agent = Model + Harness。她还分了内外两层:编程工具自带一层(系统提示词、检索代码的办法、编排),用户再为自己的项目搭一层外面的。本文讲的是后一层。
- 两者的分界:那篇 arXiv 论文说,harness 工程搭的是里面那个“行动、观察”的循环;loop 工程是从外面把这个循环组合起来,自动提示、核验、重跑,不需要人来写每一轮。
- Loop:Claude Code 团队的定义是,智能体重复一轮轮的工作,直到满足停止条件。
模型这一层:Opus 5.5 为什么适合放进循环
循环会把同一份上下文反复读很多遍,所以先看价格。下面是 Anthropic 发布文章里的数字,单位是每百万 token:
| Opus 5.5 | Opus 5 | |
|---|---|---|
| 输入 | $4 | $5 |
| 输出 | $20 | $25 |
| 缓存写入 | $5 | $6.25 |
| 缓存读取 | $0.20 | $0.50 |
最要紧的是最后一行:缓存读取降了 60%。Anthropic 在发布文章里说,缓存读取占了智能体和编码工作成本的大部分。加上每个任务用的 token 也更少,Anthropic 的测试是按默认设置、在典型的工作上比 Opus 5 便宜约 40%。
和搭循环有关的几项规格,来自 Claude 平台的模型概览:
- 模型 ID 是
claude-opus-5-5,2026 年 9 月 22 日发布,上下文 100 万 token,最大输出 12.8 万。 - 自适应思考一直开着,关不掉;思考的深浅用 effort 控制,默认是 medium。
- 输入是文字和图片,输出是文字。它能读图,后面“让模型自己看画面”那一步靠的就是这个。
- Claude Code 和 Claude 平台里有 fast mode,最高 2.5 倍速度,价格是 $8 / $40。
effort 各档怎么选、缓存怎么不白白失效,见Claude Code 怎么省用量。
如果你是通过 API 从 Opus 5 迁过来,模型概览列了四个会让旧代码出错的变化:思考不能关闭;强制使用工具会返回错误;思考块和模型、对话绑定;旧的 computer_20251124 工具在 Claude API 和 Google Cloud 上不再接受。另有一个不报错但会改变返回内容的变化:工具调用之间的文字现在放在思考块里,默认的显示设置下是空的。
Anthropic 自己也给了两句提醒,值得一起记住:到了这个水平,基准分数的差距不太能代表实际使用中的差别;模型经常怀疑自己正在被评测,要在发布前靠评测抓住所有问题,目前还做不到。
例子:让模型写一个“画某一帧”的程序
后面的每一步都拿这个例子来讲,所以先说清楚它是怎么回事。
Opus 5.5 交不出一个 mp4 文件,它交的是代码:一个知道怎么画出某一帧的程序。视频是把这个程序对每一帧各跑一遍,再把结果拼起来。整套做法只靠一条规则:一帧画面只由它的帧号决定。 第 0 帧永远长一个样,第 431 帧也永远长一个样,不依赖时钟、定时器和每次不同的随机数。这样渲染可以重复,改一处只要改一行再渲一遍,任何一帧都可以单独拿出来检查。
最小的样子是这样(取自原文):
// 一帧只由帧号决定:不用时钟,不用 Math.random
function draw(f) {
  const t = (f % 720) / 720;                        // 60 fps 下 12 秒一个循环,t 从 0 到 1
  const x = 200 + 300 * (0.5 - 0.5 * Math.cos(2 * Math.PI * t));
  ctx.fillStyle = '#fff'; ctx.fillRect(0, 0, W, H);
  ctx.fillStyle = '#111'; ctx.fillRect(x, 400, 80, 80);
}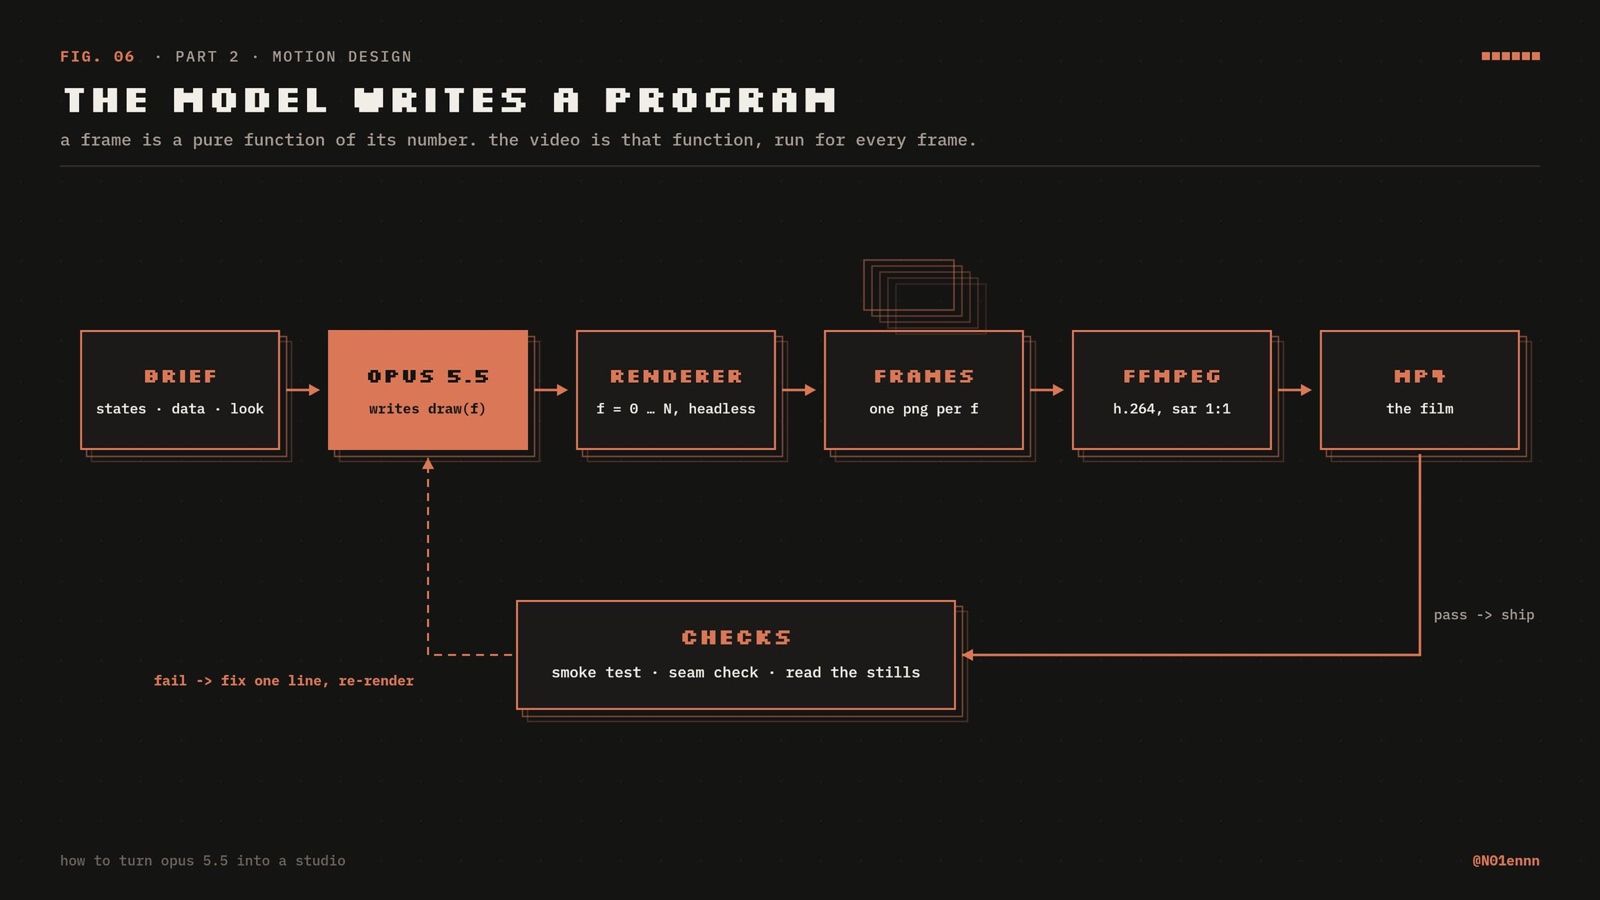
一个“工作室”有四个部分:
| 部分 | 做什么 |
|---|---|
| 舞台 | 一块固定尺寸的画布,字体嵌在文件里,不从网络加载任何东西 |
| 渲染器 | 无界面地对每一帧调用 draw(f),不开浏览器窗口,不录屏 |
| 编码器 | 用 ffmpeg 把图片合成 H.264。作者提醒要显式设置像素宽高比,否则有的播放器会把画面压扁 |
| 检查 | 大家都跳过的那部分,也是让成片看起来像样的那部分 |
模型写第一部分,另外三部分是你的。它们建好之后可以一直复用,新做一条片子只是新写一个 draw 函数。
同样的原理,本站在用 Grok Bot 做视频里讲过逐帧截图和 ffmpeg 合成的细节。这一篇关心的是另一件事:怎么让它稳定。
1写事前的规则
Böckeler 把这一类叫引导(guides):在智能体动手之前起作用,目的是让它第一次就做对的可能性更大。AGENTS.md、skill、参考文档都属于这一类。
规则文件。 作者的规则文件里,起主要作用的是五条:
- 一帧只由帧号决定:不用定时器,不用 CSS 过渡,不用没有固定种子的随机数。
- 循环要接得上:每个重复的动作,周期都要能整除循环的总长度,最后一帧才能接回第一帧。
- 颜色要有用处:底色只用黑白,颜色只放在有含义的地方。
- 只用真实数据:每个标签都查得到出处,不编数字,不编界面。
- 没检查过的不交付。
作者说每一条都来自一次失误。“循环要接得上”是因为有一次虚线边框在首尾相接处跳了一下;“字体嵌进文件”是因为有一整批截图悄悄用了替代字体,没人发现。
这正是 Böckeler 讲的人的角色:同一个问题出现不止一次,就去改规则或者加检查,让它以后不容易再出现。 规则文件里“禁止的默认做法”那一栏,就是这样一条条长出来的。
需求怎么写。 作者认为需求对结果的影响比模型还大,他的五条经验:
- 描述机制,不描述感觉。“一份会自己逐节朗读的目录”比“做得动感一点”有用。
- 每个状态都写出来。一张卡片有空闲、进行中、完成三种状态,就三种都说,各长什么样。
- 给真实的材料:数字、列表、原文。模型擅长排版,不擅长猜事实。
- 给一张参考图,并说清楚不要学什么:只学字体和间距,不学布局和内容。
- 先要方案,再要代码:分几个区域,什么放在哪,什么会动、什么时候动。
需求含糊,得到的就是每个模型都会退回去的那个默认结果:渐变背景上一个居中的标题,所有东西淡入。
在 Claude Code 里,规则文件就是 CLAUDE.md;每一类反复做的工作写成一个 skill,写法见Claude Code skills 怎么写。
2加事后的检查
Böckeler 把这一类叫传感器(sensors):在智能体做完之后观察结果,让它能自己纠正。
作者每次构建之后、自己看画面之前,先跑三项检查:
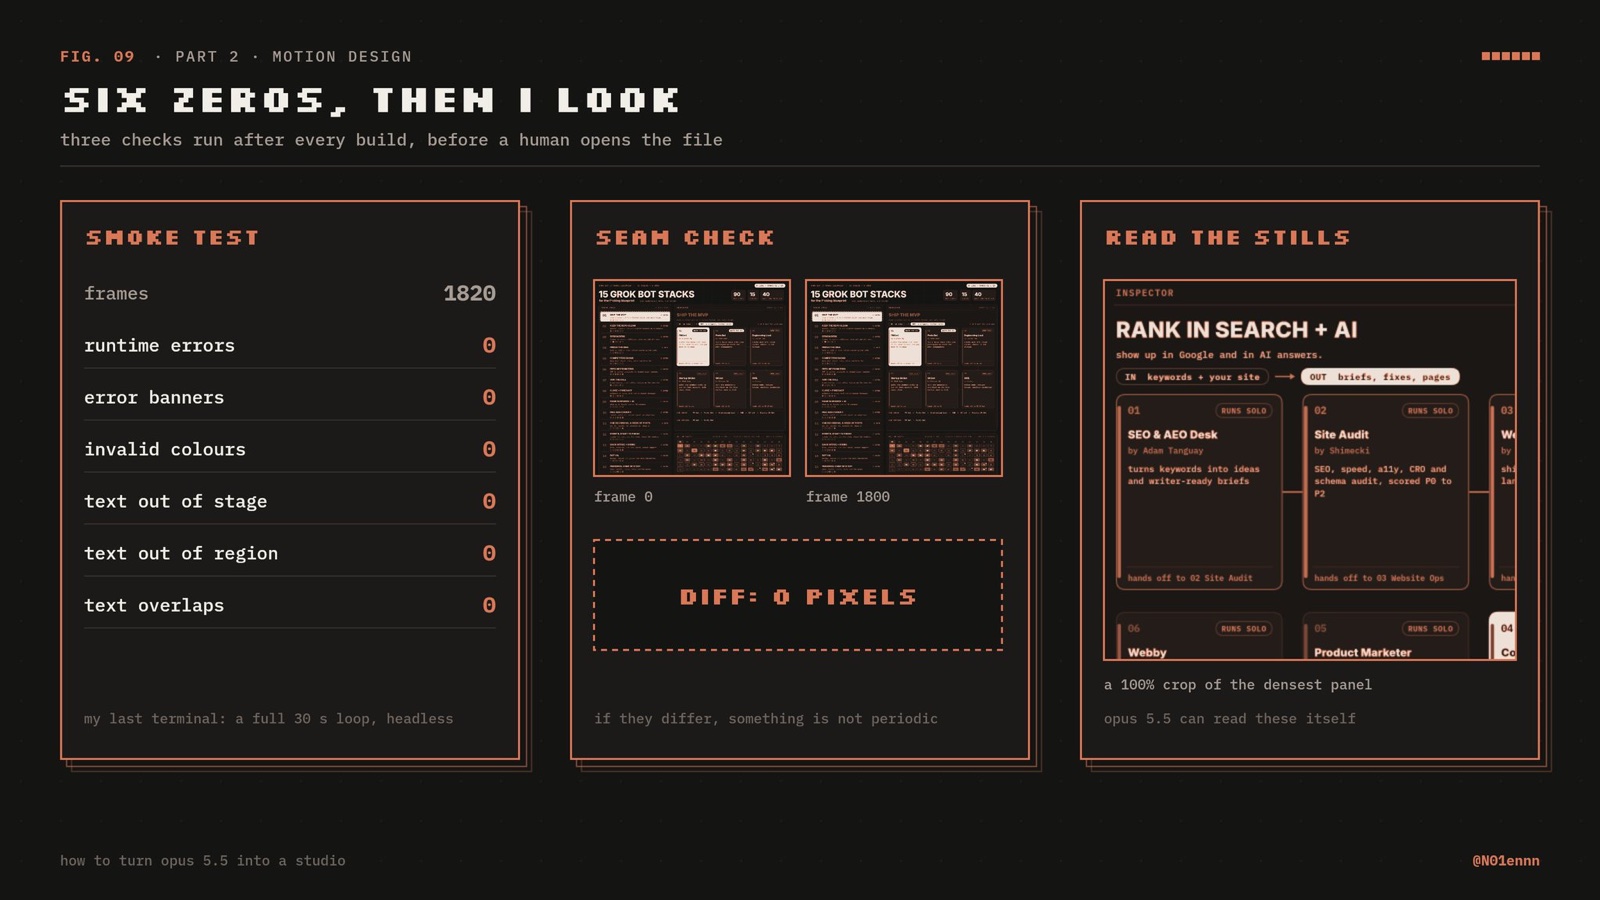
- 冒烟测试。 页面无界面地跑完一整个循环,六个计数器必须全是 0:运行时错误、错误提示条、无效的颜色、文字超出舞台、文字超出所在的面板、文字互相重叠。
- 接缝检查。 第 0 帧和整整一个循环之后的那一帧,必须每个像素都相同。不同就说明有东西不是周期性的。
- 看。 渲染几张静帧,把最密的地方按 100% 裁出来读一遍。Opus 5.5 能读图,这一遍可以让它自己先做,在你打开文件之前告诉你哪里不对。
冒烟测试的输出是这样的(取自原文):
frames             1820
runtime errors     0
error banners      0
invalid colours    0
text out of stage  0
text out of region 0
text overlaps      0
计数器能抓住眼睛漏掉的,眼睛能抓住计数器抓不到的:一条线穿过了标签,一个面板每项测试都过了却还是看着不对。
两种检查,各放在哪
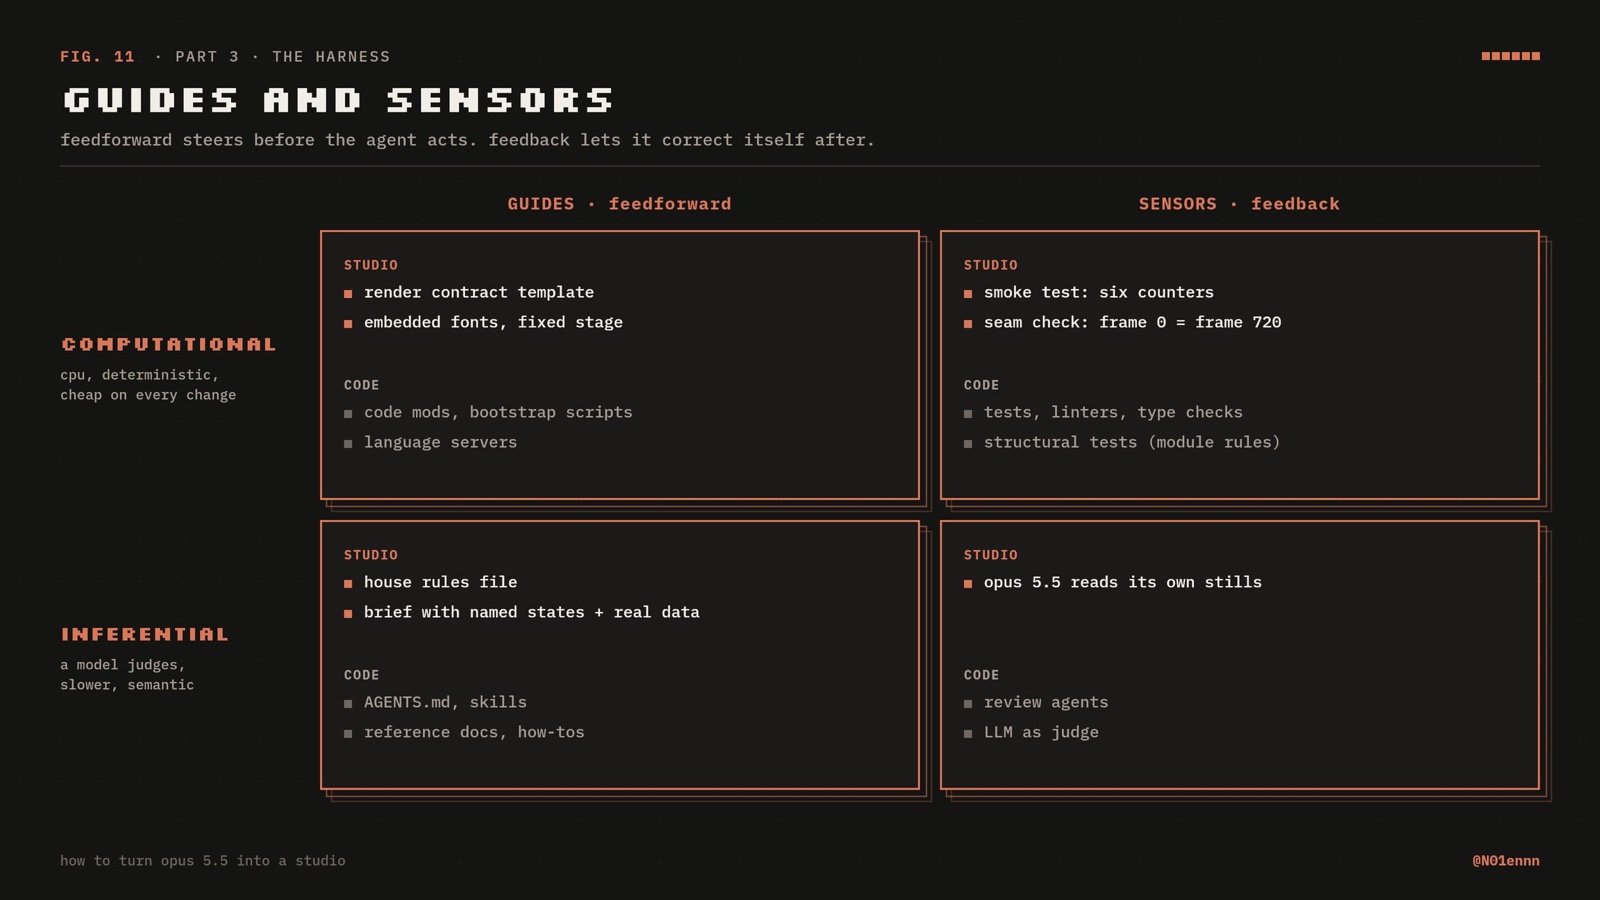
Böckeler 把引导和传感器各分成两种执行方式:
| 特点 | 代码项目里的例子 | 这个例子里 | |
|---|---|---|---|
| 计算型 | 确定、快,每次改动都能跑 | 测试、lint、类型检查、检查模块边界的结构测试 | 冒烟测试、接缝检查 |
| 推理型 | 由模型来判断,慢一些、贵一些,结果不完全确定 | 负责审查的子代理、让模型当评委 | 模型读自己渲染的静帧 |
她文章里有三点很实用:
- 报错写给模型看。 传感器的输出专门为模型写的时候最管用,比如自定义的 lint 报错里直接带上该怎么改。
- 便宜的检查往前放。 快的(lint、跑得快的测试、基本的审查)放在提交之前;贵的(变异测试、看全局的审查)放在集成之后;还有一类不跟着某次改动走,持续盯着慢慢积累的问题,比如死代码和依赖。越早发现,修起来越便宜。
- 有的东西检查不出来。 代码的可维护性最好管,现成的工具很多。功能做得对不对最难,现在多数人是给一份说明,再看 AI 写的测试是不是全绿,她认为这样对 AI 写的测试寄托得太多了。误诊、过度设计、误解了指令,没有哪种传感器能可靠地抓住。如果人一开始就没说清楚要什么,对不对就不在任何检查的能力范围之内。
把检查写成一个 skill
Claude Code 团队在博客里给了一个例子:把你手工验证的步骤写成 skill,让 Claude 自己把更多的检查做完。下面译自官方博客:
---
name: verify-frontend-change
description: 在宣布完成之前,把任何界面改动从头到尾验证一遍。
---
# 验证前端改动
不要只因为编辑成功了,就报告界面改动已完成。像人工审查那样验证:
1. 启动开发服务器,在浏览器里打开改过的页面。
2. 直接操作改动的地方。新加的控件(按钮、输入框、开关):点一下,
   确认状态按预期变化,改动前后各截一张图。
3. 看浏览器控制台:不能有新的错误或警告。
4. 用 Chrome DevTools MCP 跑一次性能跟踪,检查 Core Web Vitals。
任何一步不过,就修好问题,再从第 1 步重来。不要交回只验证了一半的东西。
官方的说法是:检查越能量化,Claude 越容易自己验证。
3包一层目标,用 /goal
有了规则和检查,下一步是让它一直做到检查通过为止。Claude Code 里做这件事的是 /goal。下面的说法都来自 Claude Code 的文档。
/goal all tests in test/auth pass and the lint step is clean- 它怎么工作。 设定之后立刻开始一轮,条件本身就是指令。每一轮结束,Claude Code 把条件和到目前为止的对话交给一个小而快的模型,它给出三种判定之一:还没满足(附上理由,Claude 接着做)、已满足(清除目标)、不可能满足(清除目标并记下原因)。
- 判定的不是干活的那个模型。 这是
/goal最有用的一点。Osmani 的说法是,写代码的模型给自己的作业打分总是太宽,/goal等于把“做的和查的分开”用在了停止条件上。 - 评估模型只看对话。 它不运行命令,也不读文件,只根据对话里已经出现的内容判断。所以条件要写成 Claude 自己的输出能证明的东西:“test/auth 里的测试全部通过”可行,因为 Claude 会去跑测试,结果会出现在对话里。
- 它不判断“好不好”。 它只判断你写的条件成立没有。条件里没写的,它不管。
- 不改变权限模式。 想让它无人值守地跑,要在 auto 模式下运行
/goal;手动模式下,没有预先允许的工具调用它照样会停下来问。 - 一个会话同时只能有一个目标。
/goal不带参数可以看状态:条件、已经跑了多久、评估了几轮、花了多少 token、最近一次判定的理由。/goal clear清除。 - 评估用的 token 按小模型计费,文档说和主回合相比通常可以忽略。
一个经得住很多轮的条件,文档说通常有三样:
| 要素 | 例子 |
|---|---|
| 一个可以测量的终点 | 测试结果、构建的退出码、文件数量、清空的队列 |
| 怎么证明 | “npm test 退出码为 0”“git status 是干净的” |
| 不能动的约束 | “不修改其他测试文件” |
条件最长 4000 个字符。要限制它跑多久,在条件里加一句轮数或时间的限制,比如 or stop after 20 turns。
回到动画的例子,作者的目标是这样写的(译自原文):
/goal 冒烟测试的六个计数器全部为 0,并且第 0 帧和第 720 帧逐像素相同。
每一轮修最严重的那个问题。某一轮什么都没修好就中止。最多 5 轮。
停止规则是机器能检查的,有轮数上限,还有“没有进展就中止”这一条。
什么时候不适合用。 Claude Code 团队写的是:目标式循环最适合有可验证的退出条件的任务,测试通过了几项、分数过没过某条线,这类确定的标准最管用。反过来,说不出“做完”是什么样的事就不适合。原文举的反例是:“一直改到这个界面好看为止”不是一个目标。
4给重复的事定时,用 /loop 和 /schedule
/goal 是朝一个条件一直做;/loop 是隔一段时间再做一次。
/loop 5m check my PR, address review comments, and fix failing CI文档里要知道的几点:
| 你给了什么 | 会怎样 |
|---|---|
间隔和提示词,如 /loop 5m 检查部署 |
按固定间隔运行 |
| 只给提示词 | 每次由 Claude 自己决定隔多久,在 1 分钟到 1 小时之间 |
| 什么都不给 | 运行内置的维护提示词;项目里有 .claude/loop.md 就用它 |
- 它是会话级的。 只在 Claude Code 开着并且空闲的时候触发。关掉终端就停了。
- 循环任务创建 7 天后自动过期,最后触发一次然后删除自己。
- 用
--resume或--continue恢复会话时,没过期的固定间隔任务会恢复;自己定节奏的/loop不会。 - 时间按你本机的时区算。实际触发会比设定的晚一点,这是有意加的错峰,最多晚 30 分钟。
要让它在你合上电脑之后还跑,得换一种:
云端(/schedule) |
桌面定时任务 | /loop |
|
|---|---|---|---|
| 在哪里跑 | 云端 | 你的电脑 | 你的电脑 |
| 要不要开着电脑 | 不用 | 要 | 要 |
| 要不要开着会话 | 不用 | 不用 | 要 |
| 能不能读本地文件 | 不能,每次是全新克隆 | 能 | 能 |
| 权限确认 | 没有,自主运行 | 每个任务可配 | 跟随会话 |
| 最短间隔 | 1 小时 | 1 分钟 | 1 分钟 |
云端的 routine 怎么配,见Claude Code 云端会话怎么用。
四种循环
Claude Code 团队按“怎么触发、怎么停”把循环分成四种,并且先说了一句:不是每个任务都需要复杂的循环,从最简单的那种开始。
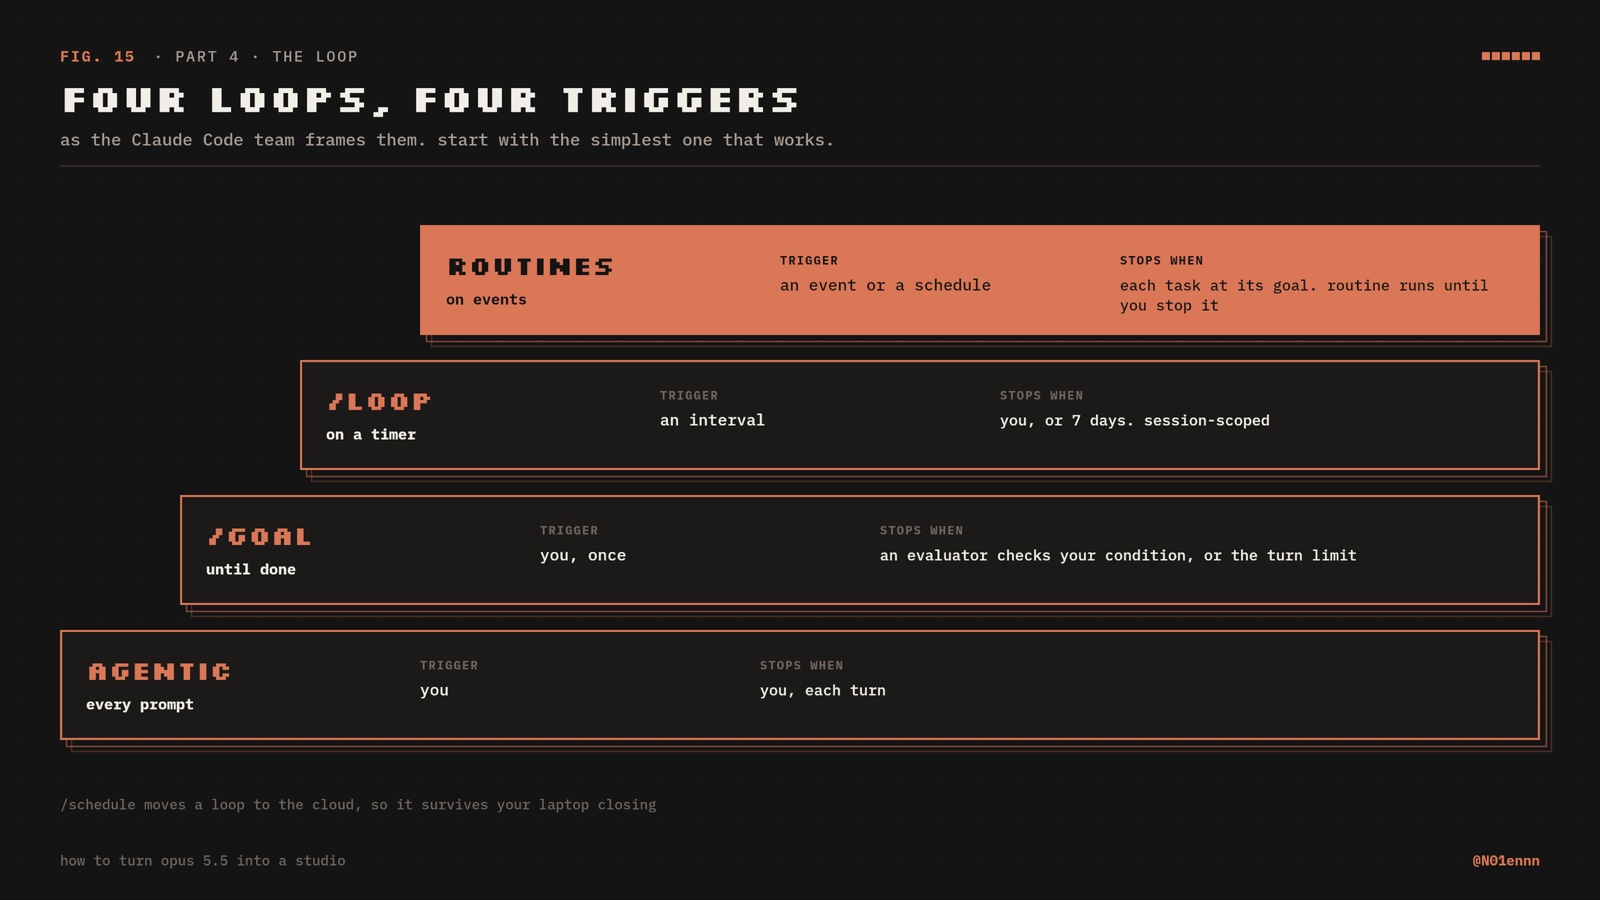
| 循环 | 怎么触发 | 怎么停 | 适合 |
|---|---|---|---|
| 回合式 | 你发一条提示词 | Claude 认为做完了,或者需要你补充 | 短的、不定期的任务 |
目标式(/goal) |
你发一次 | 条件满足,或者达到你写的轮数 | 有可验证的退出条件的任务 |
定时式(/loop、/schedule) |
到了时间 | 你取消,或者事情做完 | 反复出现的工作,或者要盯着外部系统的工作 |
| 主动式 | 事件或定时,没有人在场 | 每个任务到达目标就结束,routine 本身一直跑到你关掉 | 源源不断、定义清楚的工作:缺陷报告、分拣、迁移、依赖升级 |
主动式是把前面几样组合起来。官方博客给的例子(原文是一整段,这里为了好读分了行):
/schedule every hour: check #project-feedback for bug reports.
/goal: don't stop until every report found this run is triaged, actioned, and responded to.
When fixing a bug, use a workflow to explore three solutions in parallel worktrees
and have a judge adversarially review them.里面的“workflow”是动态工作流,见Claude Code 动态工作流怎么用。
照抄这类组合之前要留意一点:/loop 的文档写明,定时触发的提示词里,内置命令是当作普通文字交给 Claude 的,不会真的执行。/goal 写在定时的提示词里能不能真的设下一个目标,文档没有明说,以你实际跑出来的为准。
一个循环由哪些零件组成
IBM 的说明把每个循环拆成四个阶段:目标(每一轮都要对照)、行动、观察、调整。搭它用的零件,IBM 和 Osmani 列的基本是同一批:
| 零件 | 在循环里干什么 | Claude Code 里用什么 |
|---|---|---|
| 自动化 | 定节奏,自己去发现和分拣工作 | 定时任务、/loop、/goal、hooks、GitHub Actions |
| Hooks | 由事件触发的规则,适合做质量和策略检查,而且不占模型的 token | hooks |
| 工作树 | 让并行的几个代理互不干扰 | git worktree、--worktree、子代理上的 isolation: worktree |
| Skill | 把项目知识写下来,免得代理每次去猜 | SKILL.md |
| 插件和连接器 | 接上你已经在用的工具,代理才能真的动手而不是只描述 | MCP 服务器和插件 |
| 子代理 | 一个做,另一个查 | .claude/agents/ 里的子代理、代理团队 |
| 状态(IBM 叫它脊柱) | 记下试过什么、过了什么、还剩什么 | Markdown 进度文件,或者通过 MCP 接的 Linear 看板 |
最后一行看着最不起眼,Osmani 却说所有长时间运行的代理都靠它:模型在两次运行之间什么都不记得,所以记忆要放在磁盘上,不能放在上下文里。
把例子对回去
到这里再看那个动画工作室,它从头到尾就是一套 harness 加一个 loop:
| 概念 | 动画工作室里 | 代码项目里 |
|---|---|---|
| 引导 | 规则文件;写明每个状态的需求 | CLAUDE.md、skill、参考文档 |
| 计算型传感器 | 冒烟测试的六个计数器、接缝检查 | 测试、lint、类型检查 |
| 推理型传感器 | 模型读自己渲染的静帧 | 单独的审查代理 |
| 目标 | 六个 0,并且首尾帧相同 | 测试全过、Lighthouse 分数不低于 90 |
| 状态 | 失败记录,以及每次失败变成了哪条规则 | 进度文件、看板 |
| 可复用的部分 | 舞台、渲染器和检查 | skill、插件、MCP |
原文的结论是:动效设计、harness 工程、loop 工程不是三个潮流,是同一套工程,一个用在画面上,一个用在代码上。
照着搭:五步
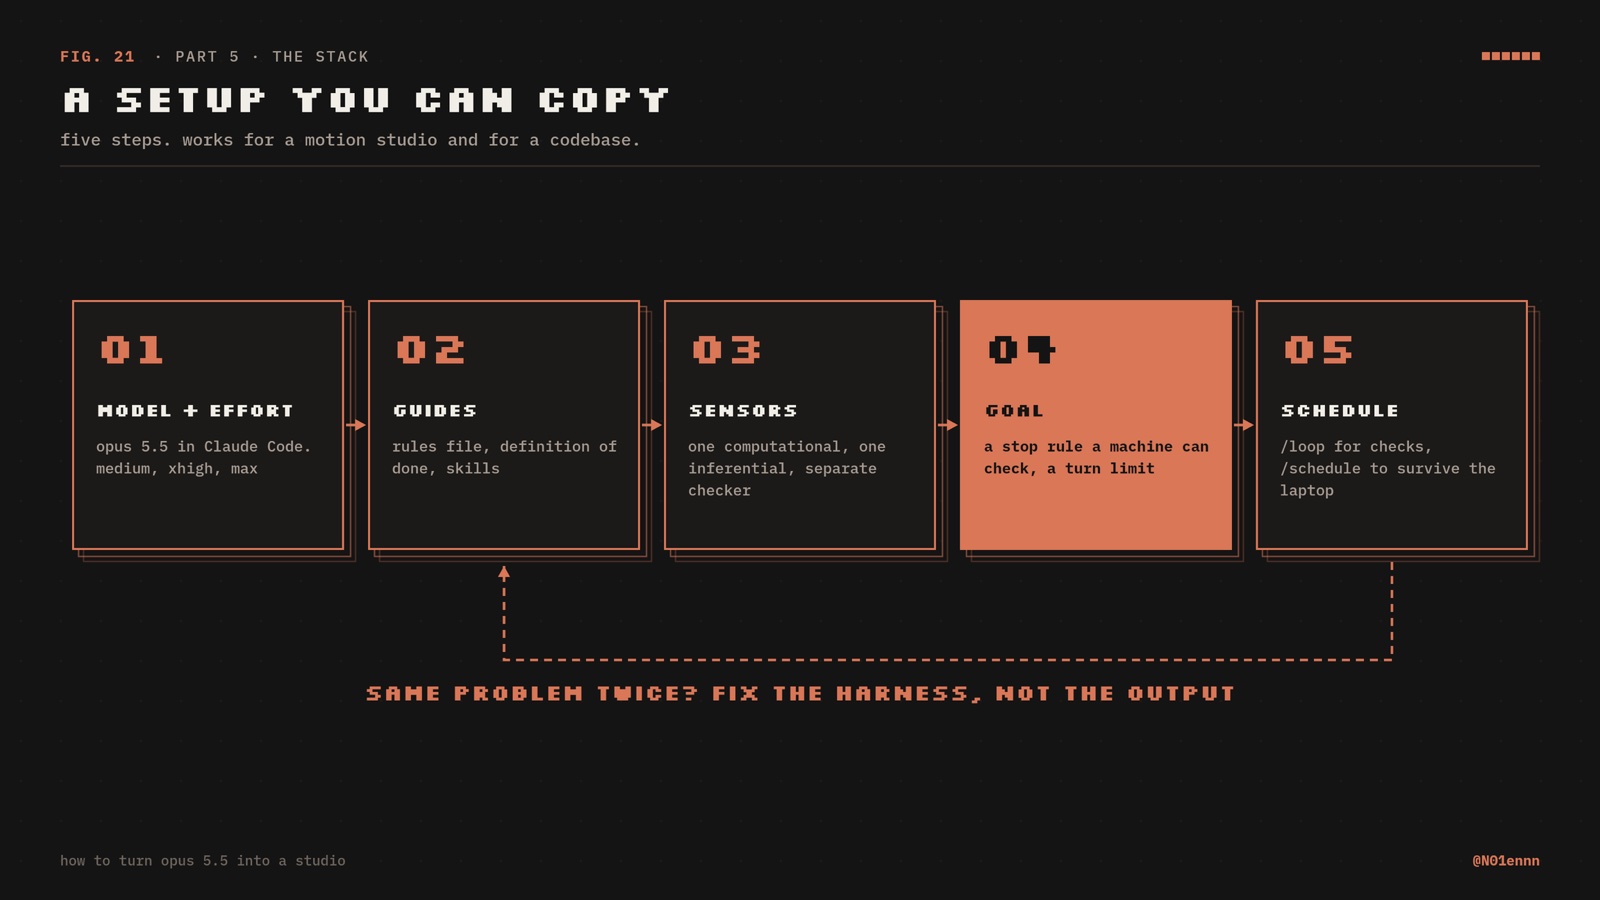
- 选模型和 effort。 作者的做法是在 Claude Code 里用 Opus 5.5,小修和重新渲染用 medium,新的工作用 xhigh,决定成败的那一遍用 max。
- 写引导。 一份
CLAUDE.md,写明约定、禁止的默认做法、什么叫做完。每一类反复做的工作一个 skill。 - 加传感器。 一项每次改动都跑的计算型检查,一项有自己指令的推理型检查。做的和查的分开。
- 包一层目标。 一条机器能检查的停止规则,一个轮数上限,一条“没有进展就中止”。
- 给重复的事定时。 本来要手工去看的用
/loop,要在合上电脑之后还跑的用/schedule。每次的结果写进状态文件,下一次从那里接着来。
贯穿每个来源的一条规则:同一个问题出现两次,不要去修那一次的产出,去修 harness。 Claude Code 团队的原话意思相同:某个结果不达标时,不要只修这一处,想办法把它写进系统,让以后每一轮都受益。
人要留在哪里
循环在没人看着的时候干活,也在没人看着的时候出错。 几个来源在这一点上说法一致。
IBM 列了人退出之后的四种风险:
| 风险 | 是什么 |
|---|---|
| 未经验证的代码 | 负责检查的代理也只是代理。交付的东西由人负责,包括它有没有泄露数据、有没有违反规定 |
| 理解债 | 代码的总量和人真正理解的部分之间的差距。它悄悄增长,因为代码都过了测试,往往到出事故时才发现 |
| 意图债 | 系统“为什么这样做”没有写在 AGENTS.md 或 skill 里,代理就会做出技术上没问题、方向上却错了的改动 |
| 认知投降 | 把一部分工作交出去没问题;循环给什么就接受什么,是失去控制 |
Osmani 的说法是:即使把做的和查的分开了,“做完了”也只是一个声明,不是证明;确认代码能用,仍然是你的事。他还特别提醒要小心 token 的花费。
关于花费,Claude Code 团队给了几条:能用简单的循环就不用复杂的;把“做完”写具体,让它早点到达;大规模运行前先拿一小部分试;确定性的工作交给脚本,不要让模型每次重新推导;定时任务不要比被盯着的东西变化得更勤。/usage 可以看各个 skill 和子代理的用量,不带参数的 /goal 可以看已经跑了几轮、花了多少。
Böckeler 的结论可以当作这一节的总结:开发者带着多年积累的习惯、对复杂度的痛感和“提交记录上是自己的名字”这份责任在写代码,代理一样都没有。Harness 是把这些东西写下来的一次尝试,但只能做到一部分。好的 harness 不是为了去掉人的输入,是为了把人的输入放到最要紧的地方。
如果你要自己做一个智能体
那篇 arXiv 论文读了 11 个编程智能体的源代码,包括 Claude Code、Codex CLI、Gemini CLI、OpenCode 和 OpenClaw,大约四百万行。对自己搭智能体的人,有几条发现和建议值得知道:
- 起点很低。 Mini-SWE-Agent 用大约 100 行实现了 harness 的全部七个子系统:一个 while 循环、一个模板、一个工具。它自己报告的 SWE-bench Verified 成绩,和比它大一千倍的系统在同一个区间(论文注明这是各家自报的数字,模型和日期不同)。
- 没有一家用通用的智能体框架,也没有一家用向量检索来找代码。 它们用的是自己写的异步循环,加上 ripgrep、glob、tree-sitter 这类确定性的检索。
- Skill 的普及超过了 MCP:11 个系统里 9 个支持
SKILL.md,8 个支持 MCP。论文的建议是 skill 用来放工作流程和领域知识,MCP 用来接外部系统。 - 从一个线性的 while 循环和一个 bash 工具开始,看到真实的失败再加工具;工具超过大约 15 个时,改成按需加载。
- 先保持单代理,直到你能指出一段确实需要并行探索的工作。论文引用的数字是多代理系统用的 token 大约是一次普通聊天的 15 倍,并注明这是和聊天比,不是和优化过的单代理流程比。
小结
原文的最后一句话是:提示词是最小的那部分,去把其余的搭起来。落到 Claude Code 上就是四样东西:一份 CLAUDE.md,一两个把检查写死的 skill,一条机器能判定的 /goal,和一个只在确实需要时才开的 /loop。
有两点本文没有替你验证:作者的动画流程本站没有实测;原文说 Opus 5.5 是“第一个让这三样同时划算的模型”,这是作者的判断,不是哪个来源里的结论。
来源
- @N01ennn:How to Turn Opus 5.5 Into a Studio: The Full Guide to Motion Design, Harnesses and Loops
- Introducing Claude Opus 5.5(Anthropic,2026-09-22)
- Claude Opus 5.5 模型概览(Claude 平台文档)
- Birgitta Böckeler:Harness engineering for coding agent users(martinfowler.com,2026-04-02)
- Barbaste 等:Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents(arXiv 2609.00006)
- Loop engineering: Getting started with loops(Claude Code 团队,2026-06-30)
- Keep Claude working toward a goal(Claude Code 文档,/goal)
- Run prompts on a schedule(Claude Code 文档,/loop)
- Addy Osmani:Loop Engineering(2026-06-07)
- What is loop engineering?(IBM,2026-07-17)